vLLMの階層的KVキャッシュオフロード
TL;DR
vLLMは階層的KVキャッシュオフロードを追加し、解放されたキー・バリュー(KV)データをホストメモリ、ファイルシステム、オブジェクトストレージ、またはピアノードに保持することで、高コストな再計算を回避し、レイテンシを低減し、LLMクラスタの有効なサービング容量を向上させます。
ホスト中心の設計で高速なメモリ解放と統合I/Oを保証
フレームワークは、すべてのKVデータが二次Tierに到達する前にホストメモリ(CPU DRAM)を経由するようにルーティングします。オフロードでは、PCIeを介してアクセラレータからホストにKVチャンクを非同期DMAでコピーし、アクセラレータメモリを即座に解放した後、非同期的にデータを二次Tier(ファイルシステム、オブジェクトストレージ、またはピア)に書き込みます。リロードは逆の流れになります:二次Tierがチャンクをホストメモリにプロモートし、その後アクセラレータに送信されます。このジャストインタイムの割り当てパターンにより、アクセラレータメモリは実際に必要とされる間のみ占有されます。
複数のGPUからのシャードを単一の共有ホスト領域に統合することで、I/O操作の数を削減し、マルチアクセラレータ環境におけるストレージおよびネットワークスループットを向上させます。
ホスト領域は標準的なメモリレイアウトを使用しています——各ページには1層の1ブロックが格納され、テンソル並列ランク間のすべてのKVヘッドが連続して集約されます。このレイアウトは設定に依存しないため、並列化設定やアテンションバックエンドが異なるノード間でもKVデータを変換せずに共有できます。
すべてのデータをホスト経由でルーティングすることで、二次Tierの実装が単純になります:各vLLMインスタンスごとに1つのプロセスで動作し、標準的なCPUベースのライブラリ(POSIX I/O、S3 SDK、RDMA verbs)を使用し、アクセラレータメモリにアクセスすることはありません。
オフロードとリロードのメカニズムは固定サイズのチャンク単位で動作
KVデータはチャンクに分割され、各チャンクはトークンのグループをカバーします。デフォルトではチャンクは1つのアクセラレータブロックに対応します。blocks_per_chunkパラメータを調整することでチャンクを大きくし、I/Oの粒度を向上させられます。
オフロードパス
- アクセラレータからホストへのKVチャンクを非同期DMAでコピー。
- ホストコピーが完了すると、すぐにアクセラレータメモリを解放。
- タイアリングマネージャーは、ホストコピーをすべて設定された二次Tierに同時にプッシュ。
- ホストTierはLRU/ARCキャッシュとして機能;容量を超えると、チャンクは二次Tierにのみエヴィクトされます。
リロードパス
- スケジューラがホストキャッシュをチェック;ヒットすれば即座にチャンクを返却。
- ホストミスの場合、二次Tierを順に問い合わせ;最初にチャンクを持つTierが提供。
- タイアがチャンクを非同期でホストメモリにプロモート;スケジューラは
RETRYを受け取り、次のサイクルで再チェック。 - 同じリクエストの異なるチャンクは、異なるTierから満たされる可能性があります(例:ファイルシステムから1つ、リモートピアから1つ)。
サポートされる二次Tier
ファイルシステムTier
- 各KVチャンクをローカルまたはネットワークストレージ上のファイルとして、コンテンツアドレス指定名前で保存。
- 複数のvLLMインスタンスが同じディレクトリをマウントすると自動的に共有。
- 非ブロッキングのルックアップ、アトミックな書き込み、分離された読み取り/書き込みスレッドプール。
vllm serve Qwen/Qwen3.6-35B-A3B \
    --kv-transfer-config '{
        "kv_connector_extra_config": {
            "spec_name": "TieringOffloadingSpec",
            "cpu_bytes_to_use": 107374182400,
            "secondary_tiers": [{"type": "fs", "root_dir": "/mnt/kv-cache"}]
        }
    }'
オブジェクトストレージTier
- NIXLを介してS3互換ストアにチャンクを永続化し、同じコンテンツアドレス指定スキームを使用。
- コスト効率が高く、ネットワーク全体にまたがるキャッシュを提供。
--kv-transfer-config '{
    "kv_connector_extra_config": {
        "spec_name": "TieringOffloadingSpec",
        "cpu_bytes_to_use": 107374182400,
        "secondary_tiers": [{
            "type": "obj",
            "bucket": "my-kv-cache",
            "endpoint_override": "http://minio:9000"
        }]
    }
}'
ピアツーピア(P2P)Tier
- ZMQによる調整とRDMAによる大容量転送を活用して、ネットワーク上でのインスタンス間KV共有を可能に。
- すべての転送はホスト間;アクセラレータメモリは関与しない。
- コンテナオーケストレーション(例:llm-d)が、どのピアから取得するかを決定。
--kv-transfer-config '{
    "kv_connector_extra_config": {
        "spec_name": "TieringOffloadingSpec",
        "cpu_bytes_to_use": 107374182400,
        "secondary_tiers": [{"type": "p2p", "host": "10.0.0.1", "port": 5710}]
    }
}'
P2Pの主なユースケース
- Prefill/Decodeの分離:PrefillノードがホストTierにKVチャンクを書き込み、DecodeノードがRDMAで取得し、計算とデータ移動を重ね合わせる。
- 負荷分散:過負荷のインスタンスが未利用のピアにチャンクをオフロードし、全体のスループットを向上。
ハイブリッドモデルとの互換性
階層的オフロードフレームワークは、vLLMのハイブリッドメモリアロケータと統合されており、すべてのKVフォーマット(フルアテンション、スライディングウィンドウ、MLA、Mambaなど)を一貫したバイトバッファ表現に正規化します。各チャンクはホスト上では層の種類にかかわらず固定バイトサイズであり、異種アーキテクチャ間での一貫したオフロードを可能にします。その結果:
- スライディングウィンドウ層は、アクティブなウィンドウトークンのみをリロード。
- ステートスペース層(例:Mamba)は、アテンションKVと共に内部ステートをオフロードおよびリロード。 サポートされるハイブリッドモデルにはDeepSeek V4、GLM 5.3、Nemotron 3などがあります。
監視とメトリクス
vLLMは標準の/metricsエンドポイントでPrometheusメトリクスを公開し、以下の内容をカバーします:
- ホストキャッシュの利用状況(フィル比率)。
- アクセラレータ↔ホスト間の転送スループット。
- 各Tierごとのルックアップおよび転送レイテンシ。
- 各Tierごとのヒット率。 二次Tierは、カスタムカウンタ、ヒストグラム、ゲージを登録でき、自動的に公開されます。
KVイベントで知的なオーケストレーションを可能に
チャンクがTier間を移動するたび、フレームワークは構造化されたKVイベントを発行し、チャンクキー、元Tier、先Tier、およびローカル/リモートの局所性を示します。llm-dやDynamoなどのオーケストレーションシステムはこれらのイベントを消費し、キャッシュヒットの可能性が最も高いインスタンスにリクエストをルーティングし、P2P転送をトリガーすることで、キャッシュ非対応スケジューリングよりも高いスループットと低いレイテンシを実現します。
新しい二次Tierの拡張
二次Tierは以下の4つのメソッドを実装します:
class SecondaryTierManager(ABC):
    def lookup(self, key, req_context) -> LookupResult: ...
    def submit_store(self, job_metadata: JobMetadata) -> None: ...
    def submit_load(self, job_metadata: JobMetadata) -> None: ...
    def get_finished_jobs(self) -> Iterable[JobResult]: ...
マネージャーは共有ホスト領域への直接memoryviewを受け取り、ゼロコピーでの読み書きが可能。エヴィクションポリシーは各Tierごとに独立して管理されます。インメモリの参照実装はvllm/v1/kv_offload/tiering/example/にあります。ツリー外のTierは、Tier設定でmodule_pathを指定することでロードできます。
スケール時のパフォーマンス:オフロードは再計算を上回る
2 × NVIDIA H100(TP=2)でQwen 3.6‑35B‑A3Bをベンチマークした結果:
- 最大約64同時会話:アクセラレータメモリがすべてのワーキングセットを保持;すべてのキャッシュ戦略が同程度に動作。
- 64–128会話:アクセラレータメモリが飽和;オフロードなしではスループットが崩壊するが、CPUオフロードではパフォーマンスを維持。
- 128会話以上:CPUキャッシュも満杯に;ストレージバックエンドのオフロードは高いヒットレートを維持し、再計算完全な状態と比べてスループットが2倍以上。
使用したストレージTierはローカルNVMeファイルシステム。ストレージレイテンシはCPUメモリより高いものの、ストレージからのキャッシュヒットは再プリフィルよりもはるかに安価です。
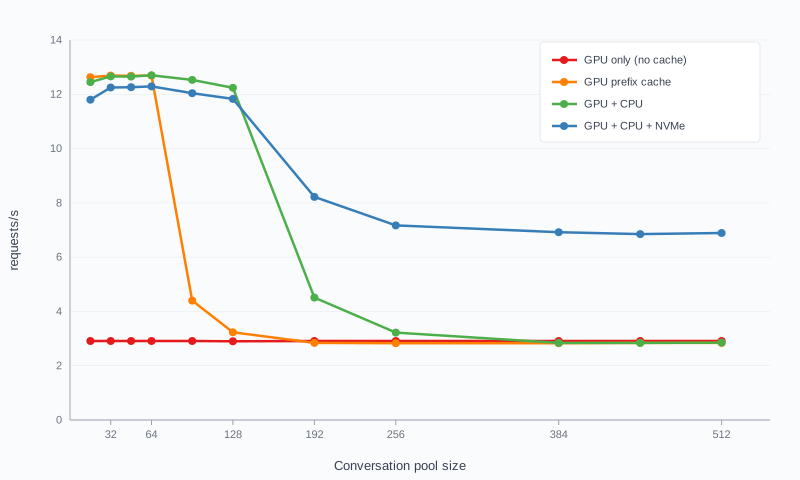
完全なベンチマークスクリプトと結果はneuralmagic/fs-offload-experimentsにホストされています。
謝辞
階層的KVキャッシュオフロードフレームワークへの貢献を、Liran Schour、Chang Guo、Srinivas Krovvidi、Rotem Shavitt、Effi Ofer、Omer Paz、Kfir Toledo、Michal Malka、および広範なコミュニティに感謝します。