vLLM 分層 KV 快取卸載
簡要說明
vLLM 新增了分層 KV 快取卸載功能,可將被驅逐的鍵值(KV)資料保留在主機記憶體、檔案系統、物件儲存或對等節點中,消除昂貴的重新計算,降低延遲,並提升 LLM 群集的有效服務容量。
以主機為中心的設計,確保快速記憶體釋放與整合 I/O
該框架在任何次要層級之前,將所有 KV 資料路由至主機記憶體(CPU DRAM)。卸載時,透過 PCIe 將 KV 區塊從加速器複製到主機,立即釋放加速器記憶體,然後非同步地將資料寫入次要層級(檔案系統、物件儲存或對等節點)。重新載入時則反向進行:次要層級將區塊提升回主機記憶體,之後加速器接收該資料。這種即時配置模式確保加速器記憶體僅在實際需要時才被佔用。
將多個 GPU 的分片整合至單一共享主機區域,可減少 I/O 操作次數,提升多加速器設定下的儲存與網路吞吐量。
主機區域使用標準記憶體配置——每個頁面儲存一個層的單一區塊,所有跨張量平行排名的 KV 頭部連續聚集。由於配置獨立,具有不同平行設定或注意力後端的節點可無需轉換即可共享 KV 資料。
將所有資料路由至主機也讓次要層級的實作變得簡單:它們作為 vLLM 實例的單一程序運作,使用標準的 CPU 基礎函式庫(POSIX I/O、S3 SDK、RDMA verbs),且從不接觸加速器記憶體。
卸載與重新載入機制以固定大小區塊為單位
KV 資料被分割為區塊,每個區塊涵蓋一組 token。預設情況下,一個區塊對應一個加速器區塊;blocks_per_chunk 參數可擴大區塊以提高 I/O 精細度。
卸載路徑
- 非同步地透過 DMA 將 KV 區塊從加速器傳送到主機。
- 一旦主機副本完成,立即釋放加速器記憶體。
- 分層管理器同時將主機副本推送到所有已設定的次要層級。
- 主機層作為 LRU/ARC 快取;區塊會留在主機記憶體中,直到容量超過,才會被驅逐至次要層級。
重新載入路徑
- 排程器檢查主機快取;命中時立即回傳區塊。
- 若主機快取未命中,依序查詢次要層級;第一個擁有該區塊的層級提供資料。
- 該層級非同步地將區塊提升回主機記憶體;排程器收到
RETRY,在下一週期重新檢查。 - 同一請求的不同區塊可能由不同層級提供(例如,一個來自檔案系統,另一個來自遠端對等節點)。
支援的次要層級
檔案系統層
- 使用內容位址命名,將每個 KV 區塊儲存為本地或網路儲存上的檔案。
- 當多個 vLLM 實例掛載相同目錄時,自動共享。
- 非阻塞查詢、原子寫入、分離的讀取/寫入執行緒池。
vllm serve Qwen/Qwen3.6-35B-A3B \
    --kv-transfer-config '{
        "kv_connector_extra_config": {
            "spec_name": "TieringOffloadingSpec",
            "cpu_bytes_to_use": 107374182400,
            "secondary_tiers": [{"type": "fs", "root_dir": "/mnt/kv-cache"}]
        }
    }'
物件儲存層
- 透過 NIXL 將區塊持久化至 S3 兼容儲存,使用相同的內容位址方案。
- 提供成本效益高、跨網路的快取。
--kv-transfer-config '{
    "kv_connector_extra_config": {
        "spec_name": "TieringOffloadingSpec",
        "cpu_bytes_to_use": 107374182400,
        "secondary_tiers": [{
            "type": "obj",
            "bucket": "my-kv-cache",
            "endpoint_override": "http://minio:9000"
        }]
    }
}'
對等(P2P)層
- 透過 ZMQ 協調與 RDMA 執行跨實例 KV 共享,實現網路傳輸。
- 所有傳輸皆為主機到主機;不涉及加速器記憶體。
- 協調系統(例如 llm-d)決定從哪個對等節點拉取資料。
--kv-transfer-config '{
    "kv_connector_extra_config": {
        "spec_name": "TieringOffloadingSpec",
        "cpu_bytes_to_use": 107374182400,
        "secondary_tiers": [{"type": "p2p", "host": "10.0.0.1", "port": 5710}]
    }
}'
P2P 的關鍵使用情境
- 預填/解碼分離:預填節點將 KV 區塊寫入其主機層;解碼節點透過 RDMA 拉取,重疊計算與資料傳輸。
- 負載平衡:過載的實例可將區塊卸載至使用率較低的對等節點,提升整體吞吐量。
混合模型相容性
分層卸載框架與 vLLM 的混合記憶體配置器整合,將所有 KV 格式(完整注意力、滑動視窗、MLA、Mamba 等)統一為一致的位元組緩衝表示。每個區塊在主機上具有固定的位元組大小,與層類型無關,允許跨異質架構的一致卸載。因此:
- 滑動視窗層僅重新載入活躍視窗的 token。
- 狀態空間層(例如 Mamba)會與注意力 KV 一同卸載與重新載入其內部狀態。 支援的混合模型包括 DeepSeek V4、GLM 5.3、Nemotron 3 等。
可觀測性與指標
vLLM 在標準的 /metrics 端點公開 Prometheus 指標,涵蓋:
- 主機快取使用率(填滿比率)。
- 加速器 ↔ 主機傳輸吞吐量。
- 各層級的查詢與傳輸延遲。
- 各層級的命中率。 次要層級可註冊自訂計數器、直方圖或儀表,並自動公開。
KV 事件支援智慧協調
每次區塊在層級間移動時,框架會發出結構化的 KV 事件,包含區塊金鑰、來源層級、目標層級與區域性(本地或遠端)。協調系統如 llm-d 和 Dynamo 消費這些事件,以將請求路由至最可能命中快取的實例,並觸發 P2P 傳輸,從而實現比快取無知排程更高的吞吐量與更低的延遲。
透過新次要層級擴展系統
次要層級需實作四個方法:
class SecondaryTierManager(ABC):
    def lookup(self, key, req_context) -> LookupResult: ...
    def submit_store(self, job_metadata: JobMetadata) -> None: ...
    def submit_load(self, job_metadata: JobMetadata) -> None: ...
    def get_finished_jobs(self) -> Iterable[JobResult]: ...
管理器接收對共享主機區域的直接 memoryview,支援零複製讀寫。驅逐策略由各層級獨立管理。內存參考實作位於 vllm/v1/kv_offload/tiering/example/。外部層級可透過在層級設定中指定 module_path 加載。
擴展規模的效能:卸載勝過重新計算
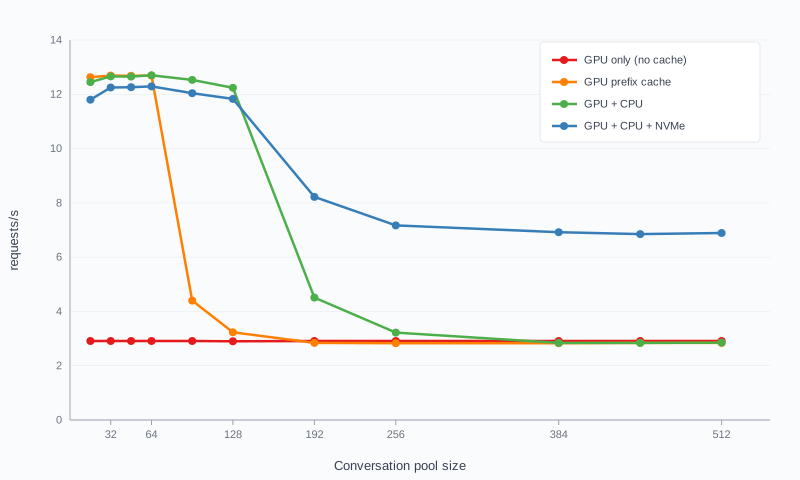
在 2 × NVIDIA H100(TP=2)上以 Qwen 3.6‑35B‑A3B 執行基準測試顯示:
- 最多約 64 個並行對話:加速器記憶體可容納整個工作集;所有快取策略表現相近。
- 64–128 個對話:加速器記憶體飽和;無卸載時吞吐量崩潰,而 CPU 卸載維持性能。
128 個對話:CPU 快取也填滿;基於儲存的卸載仍維持高命中率,且吞吐量超過全重新計算的兩倍。
所用儲存層級為本地 NVMe 檔案系統。儘管儲存延遲高於 CPU 記憶體,但來自儲存的快取命中仍遠比重新預填模型便宜。
完整基準測試程式碼與結果位於 neuralmagic/fs-offload-experiments。
致謝
感謝 Liran Schour、Chang Guo、Srinivas Krovvidi、Rotem Shavitt、Effi Ofer、Omer Paz、Kfir Toledo、Michal Malka,以及整個社群對分層 KV 快取卸載框架的貢獻。