✷ 创客
我把一台 30 块钱的玩具机器人,改成了会顶嘴的 AI 机器人
一台闲鱼上淘来的玩具机器人,一部旧安卓手机,一块 FT232H 小板子,几根线、一张纸板、两根橡皮筋。一个月后,它会听你说话、会自己开、会回嘴,被人学狗叫两声还会掉头逃跑。这篇讲它是怎么一步步拼起来的,以及路上踩过的那些很蠢、但很好笑的坑。
这个项目的起点是 Mario Zechner 的一篇文章,《How to build a shitty robot》。Mario 是 Pi agent 的作者。他在玩具店花 10 欧元买了一台玩具机器人,拆开,接上一块 FT232H,让手机通过 WebUSB 去开它,再把他自己基于 pi 写的 agent 装进去当大脑。
读完我就想给孩子也做一台。有个能陪着玩的小伙伴,这是一半理由。
另一半跟学习有关。市面上的 AI APP,大多是对着题目拍张照,答案就出来了。我不想让孩子这样用 AI。我希望孩子学会的是跟 AI 对话:把自己不懂的地方说清楚,听完回答再追问一句,觉得不对就反驳回去。一道题就这样被聊明白了,而不只是被答出来。
我觉得这本身就是一种技能,而且会越来越重要。一台得用嘴问、还会回嘴的机器人,正好逼着人去练它。
我照着他的骨架走:同样是手机当大脑,同样是 FT232H 和 WebUSB。但我选了一台不一样的机器人,大脑也放在了不一样的地方,后面的坑于是全都不一样。
一、先买一台最便宜的
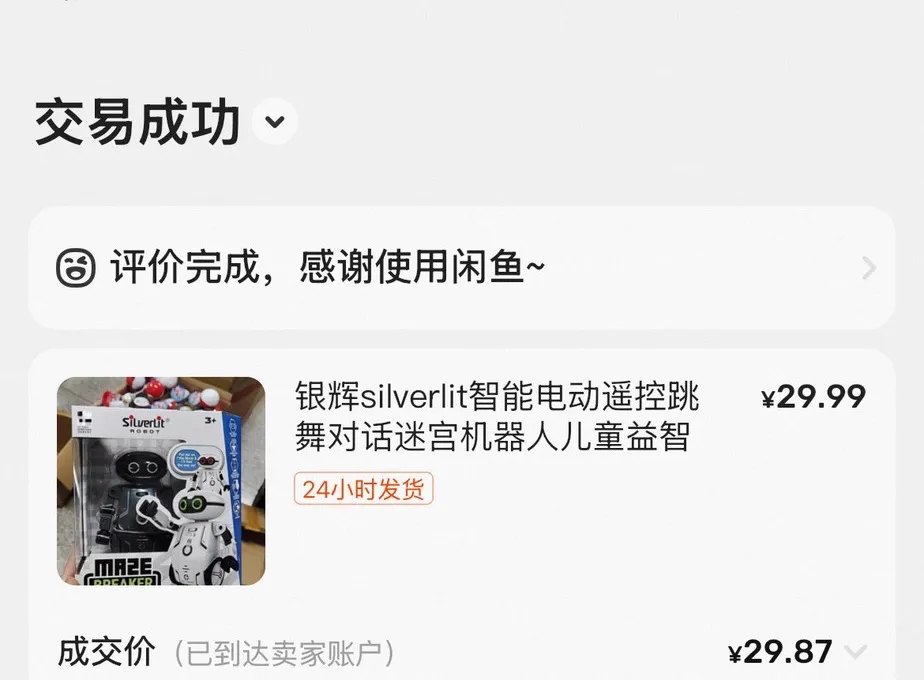
主角是银辉(Silverlit)的 Maze Breaker,在闲鱼上 29.87 元买的,折合大约 4 美元。
巧的是,Mario 那台也是银辉的,型号是 YCOO NEO OCTOBOT。它用腿走路,转弯靠转头,而且只能往一个方向转。我这台底下是履带,转向另有一套机构(下一节讲),能左右两边转。
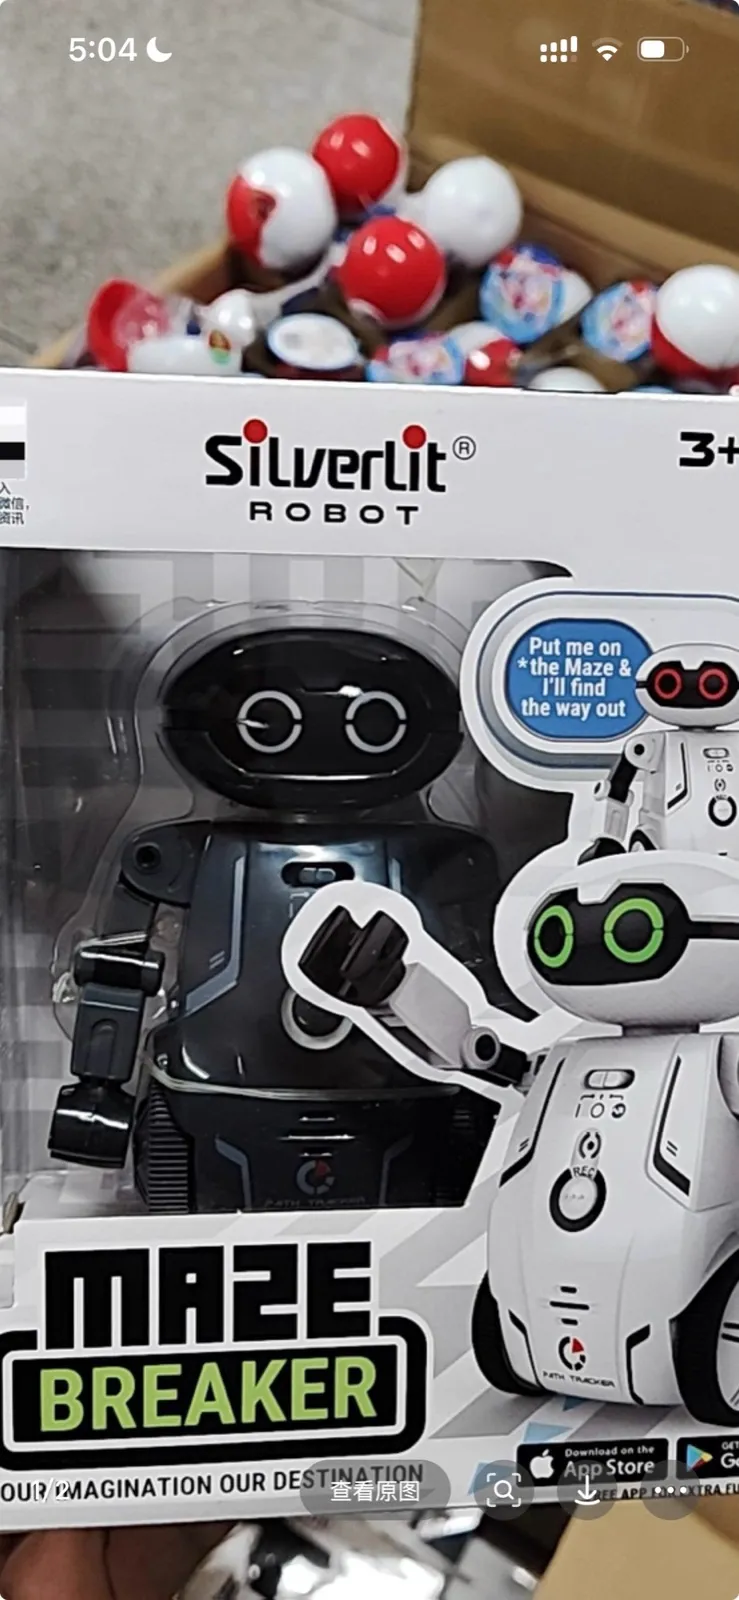
挑它没什么特别的理由。我没找到和 Mario 一样的那台,转念一想,这类玩具的原理大同小异,无非是电机加驱动芯片。真不行就再换一台,反正 30 块钱,拆坏了也不心疼。
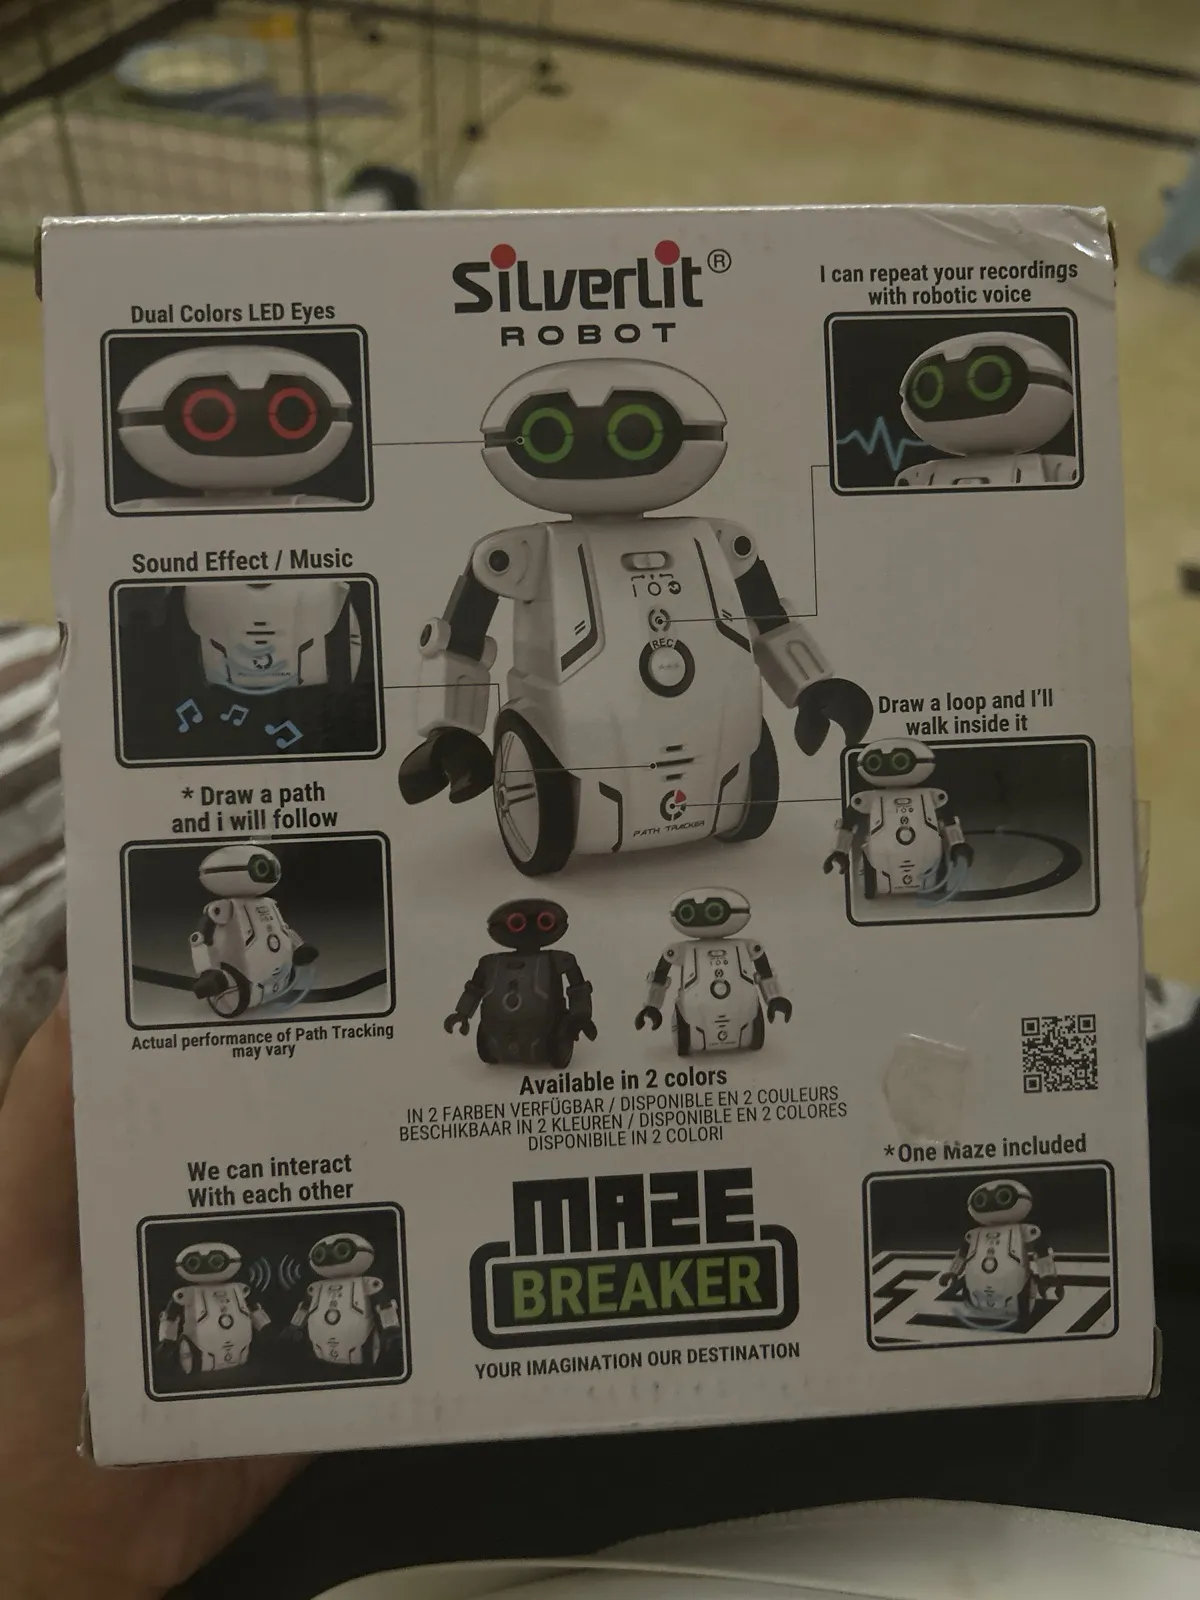
盒子背面写着它原本会的本事:在地上画一条线,它沿着线走;放进迷宫,它自己找出口;还能把你的录音用机器人腔复读一遍。也就是说,它本来就有麦克风和喇叭,只是没有脑子。
二、拆开看看里面是什么
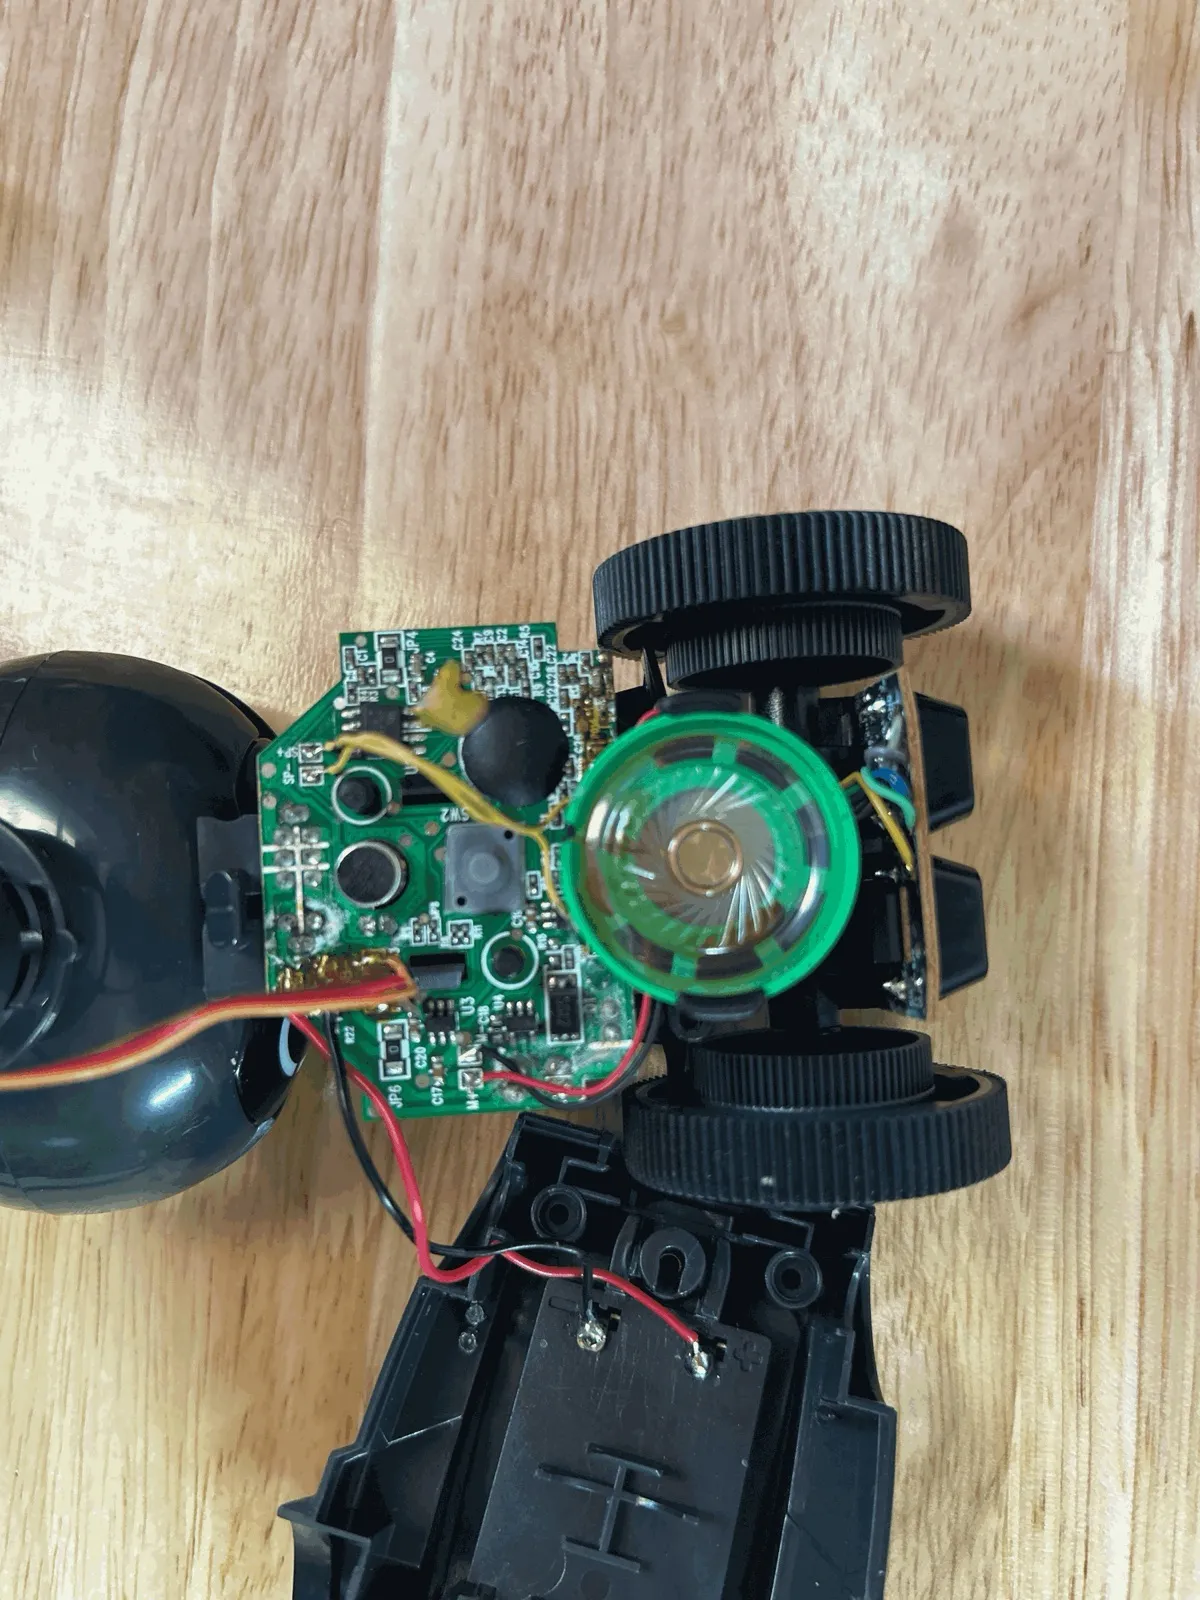
拆开之后是一块绿色的小板子、一个喇叭,底下是电池仓和履带底盘。东西比想象中少,但有一处很巧妙:它只有一个电机。
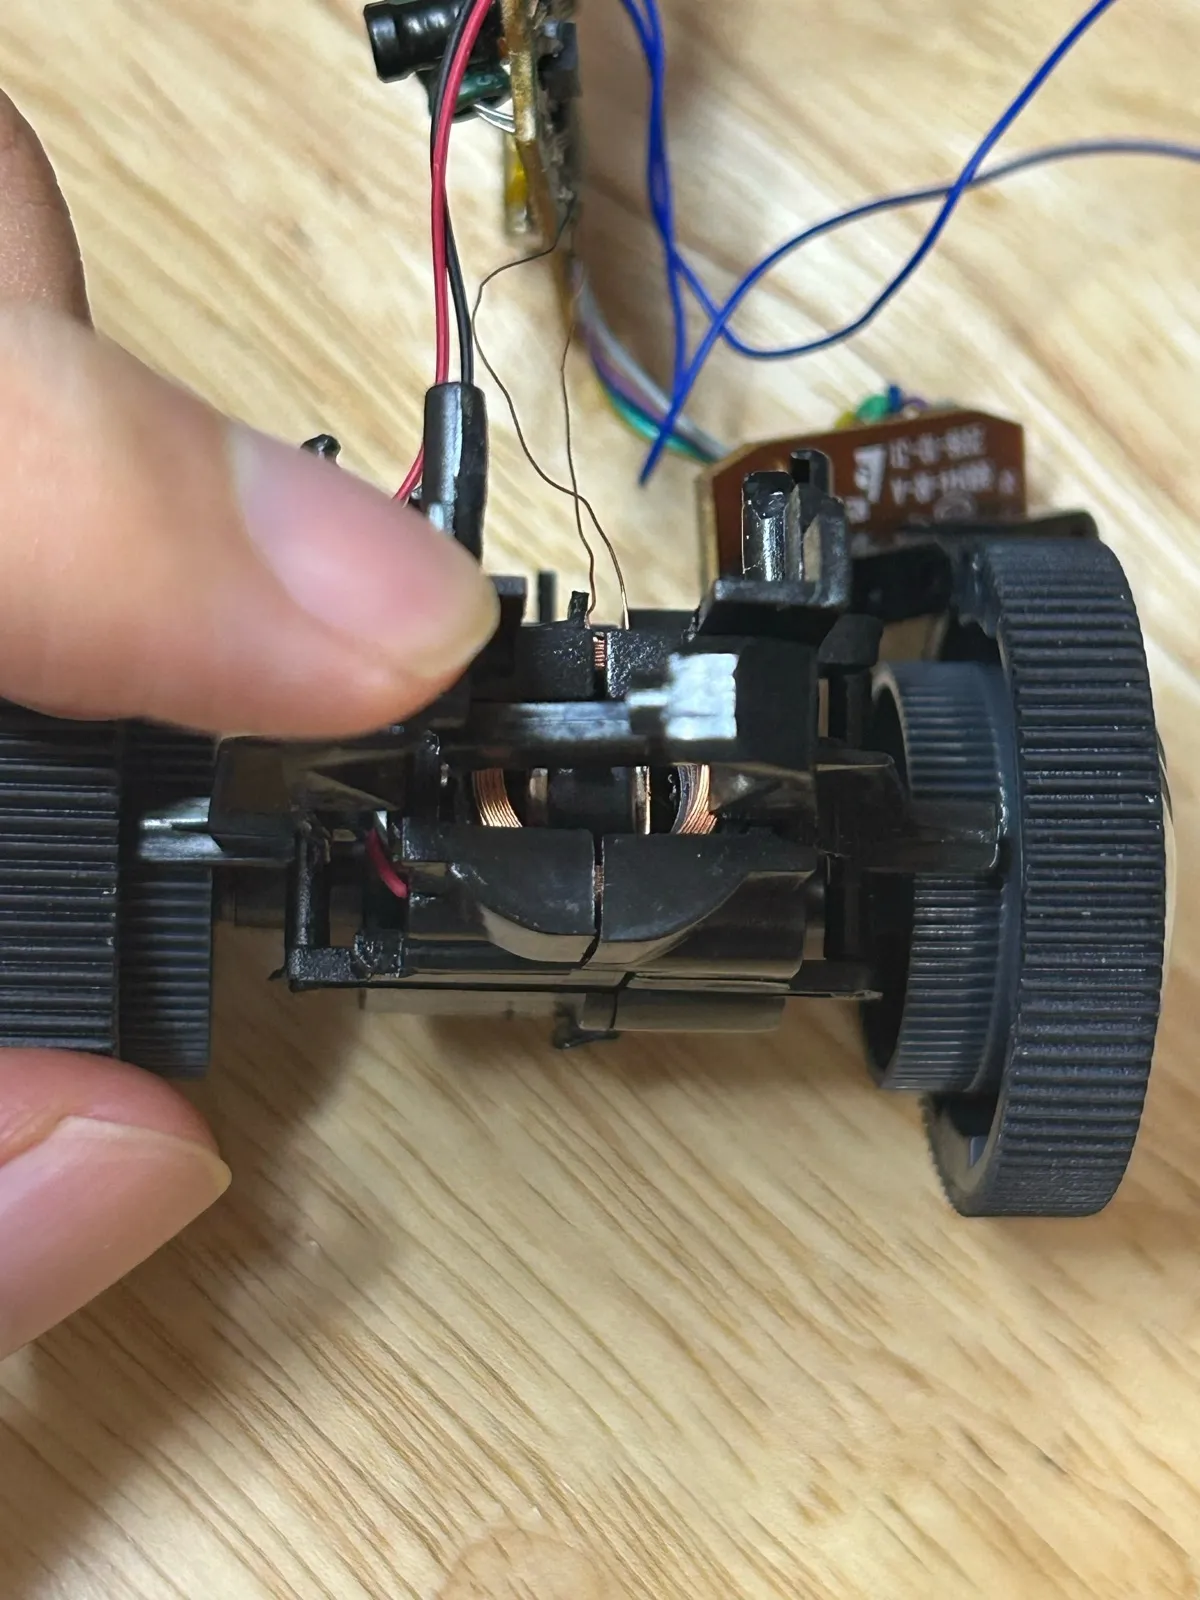
我原以为转向是两边轮子差速,结果不是。转向靠的是一个小电磁铁:线圈旁边挂着一块带永磁体的衔铁,电流正着走,衔铁甩向一边;反着走,甩向另一边;断电,弹簧把它拉回中间。便宜遥控车大多就是这么转弯的。
所以板子上有两颗驱动芯片:U3 管电机(前进、后退),U5 管电磁铁(左、右)。两颗芯片,每颗两个输入,一共四根线。谁控制了这四根线,谁就控制了这台车。
三、四根线,接到手机上
思路很直接:把原厂的大脑晾在一边,从外面接四根线,直接去推那两颗驱动芯片的输入脚。
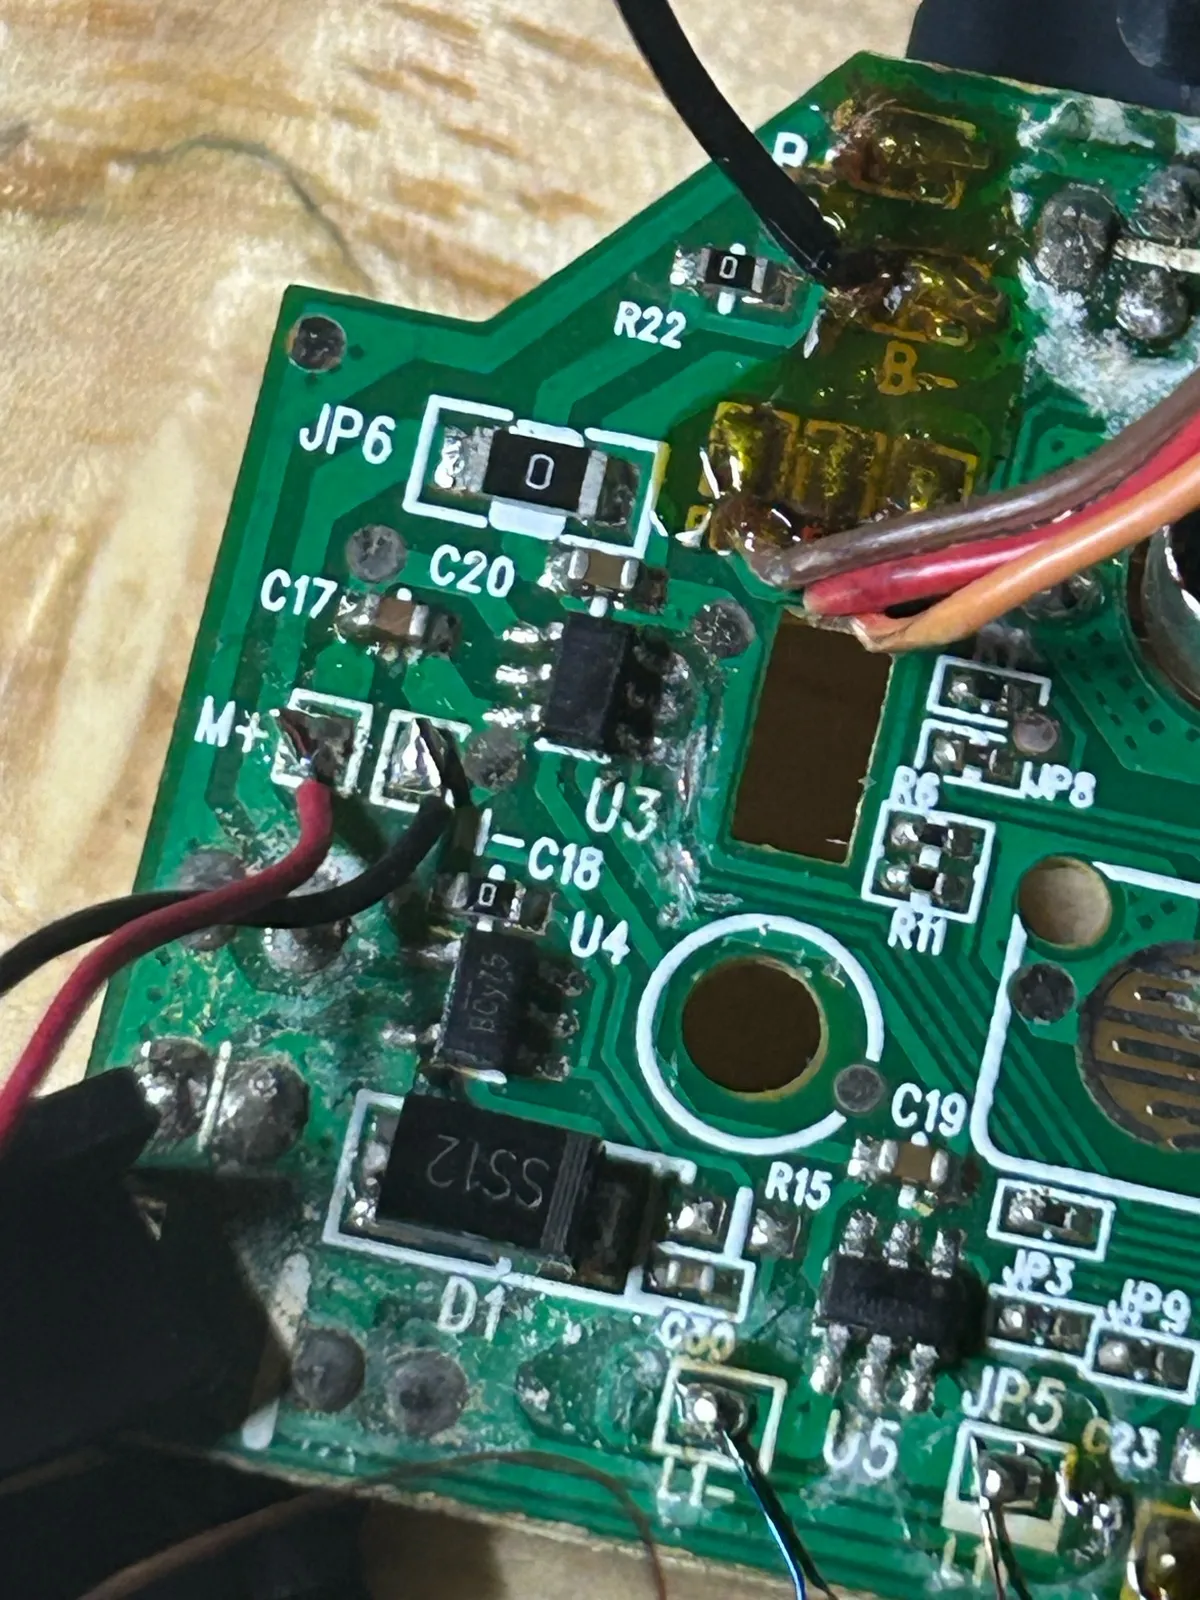
原厂的大脑是一颗封在黑胶下面的芯片(板子下方那个黑色圆点)。第一步是把它和 U3 之间的走线切断,不然两边会抢着控制电机。
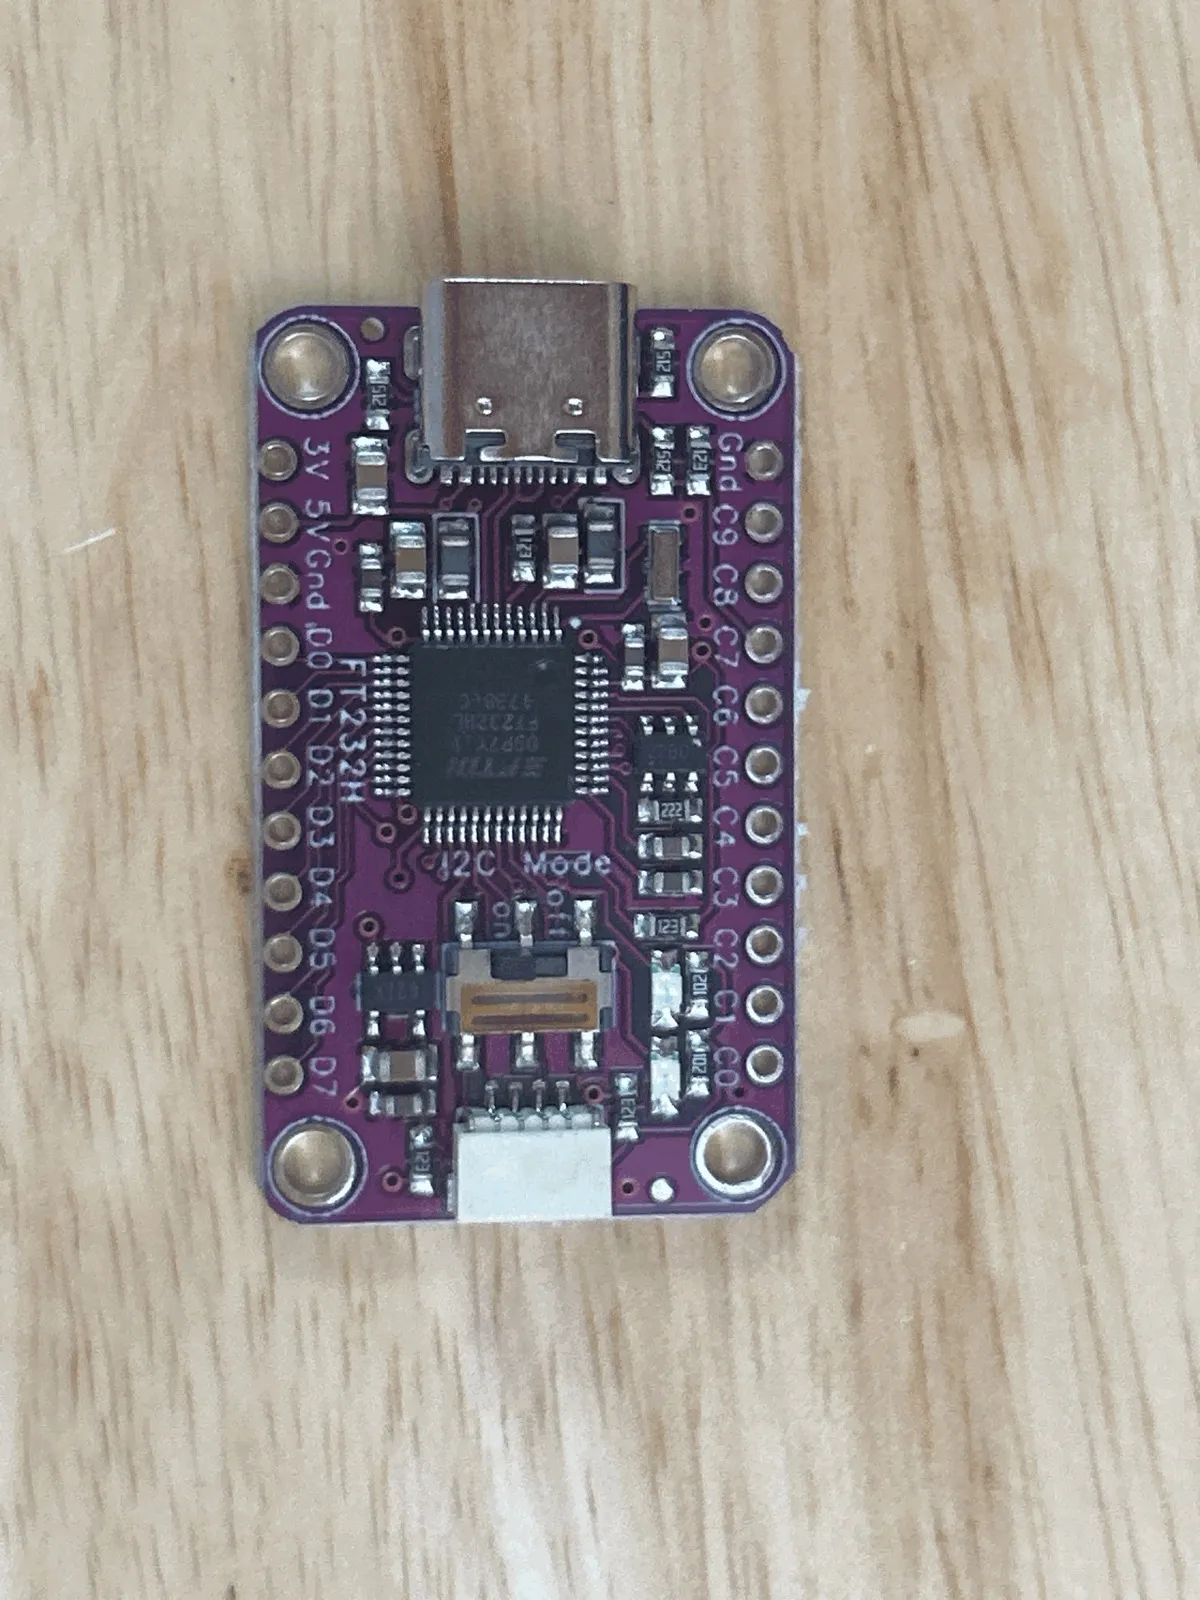
推线的是这块 FT232H。它一头是 USB-C,另一头有一排可以被随意拉高拉低的引脚。手机用 USB 线插上它,网页通过 WebUSB 跟它说话,每个字节就是一组引脚状态:0x10 是前进,0x00 是全停。
然后就是焊。
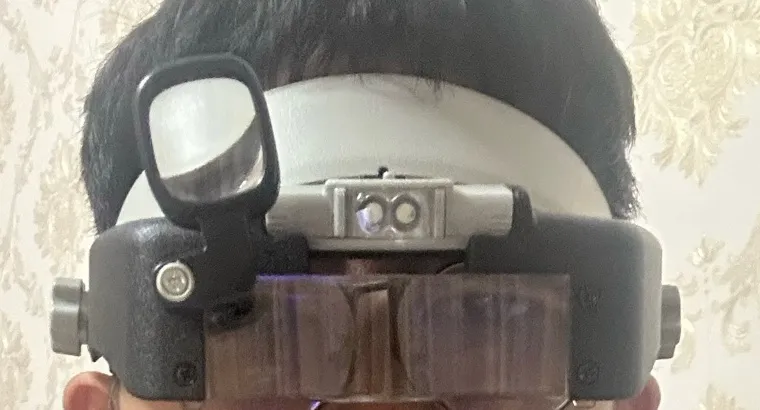
这块板子上的焊点和焊盘小得离谱,肉眼根本对不准,我只好戴上这种头戴式放大镜。样子很傻,但很管用。
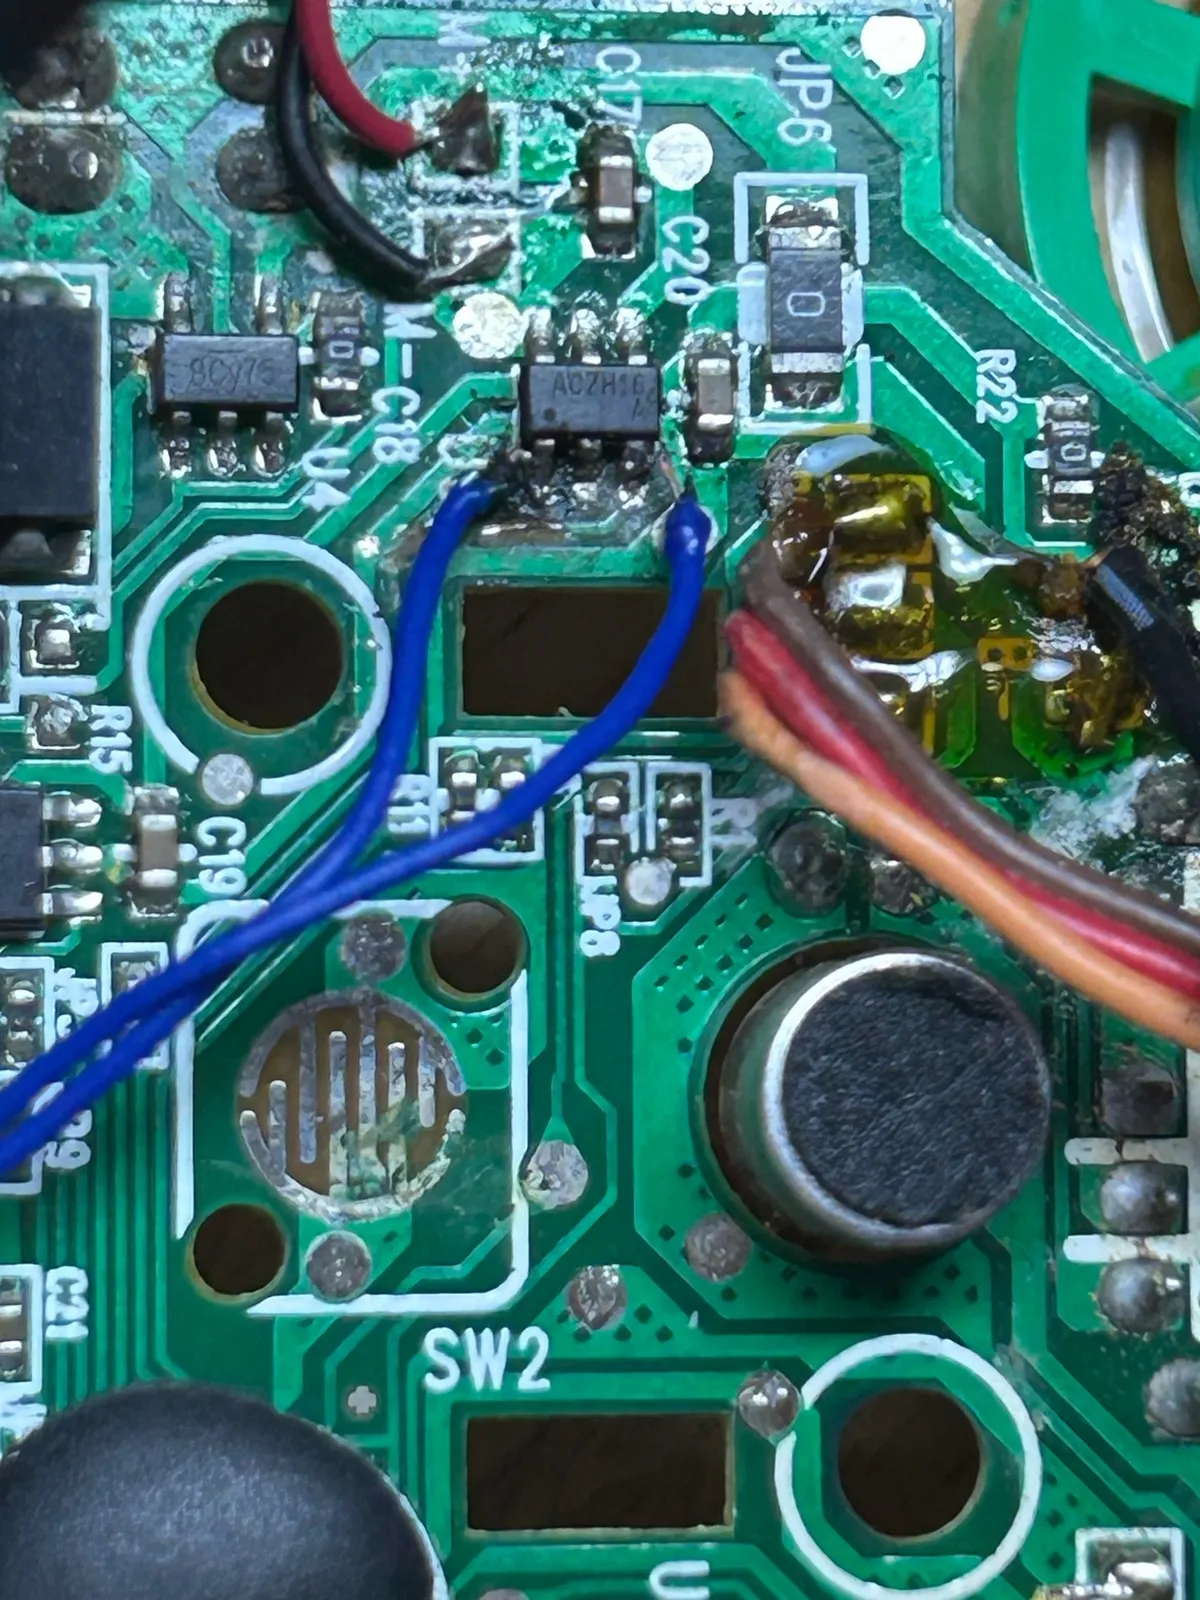
先接 U3。两根蓝线焊上去,车能前进后退了。
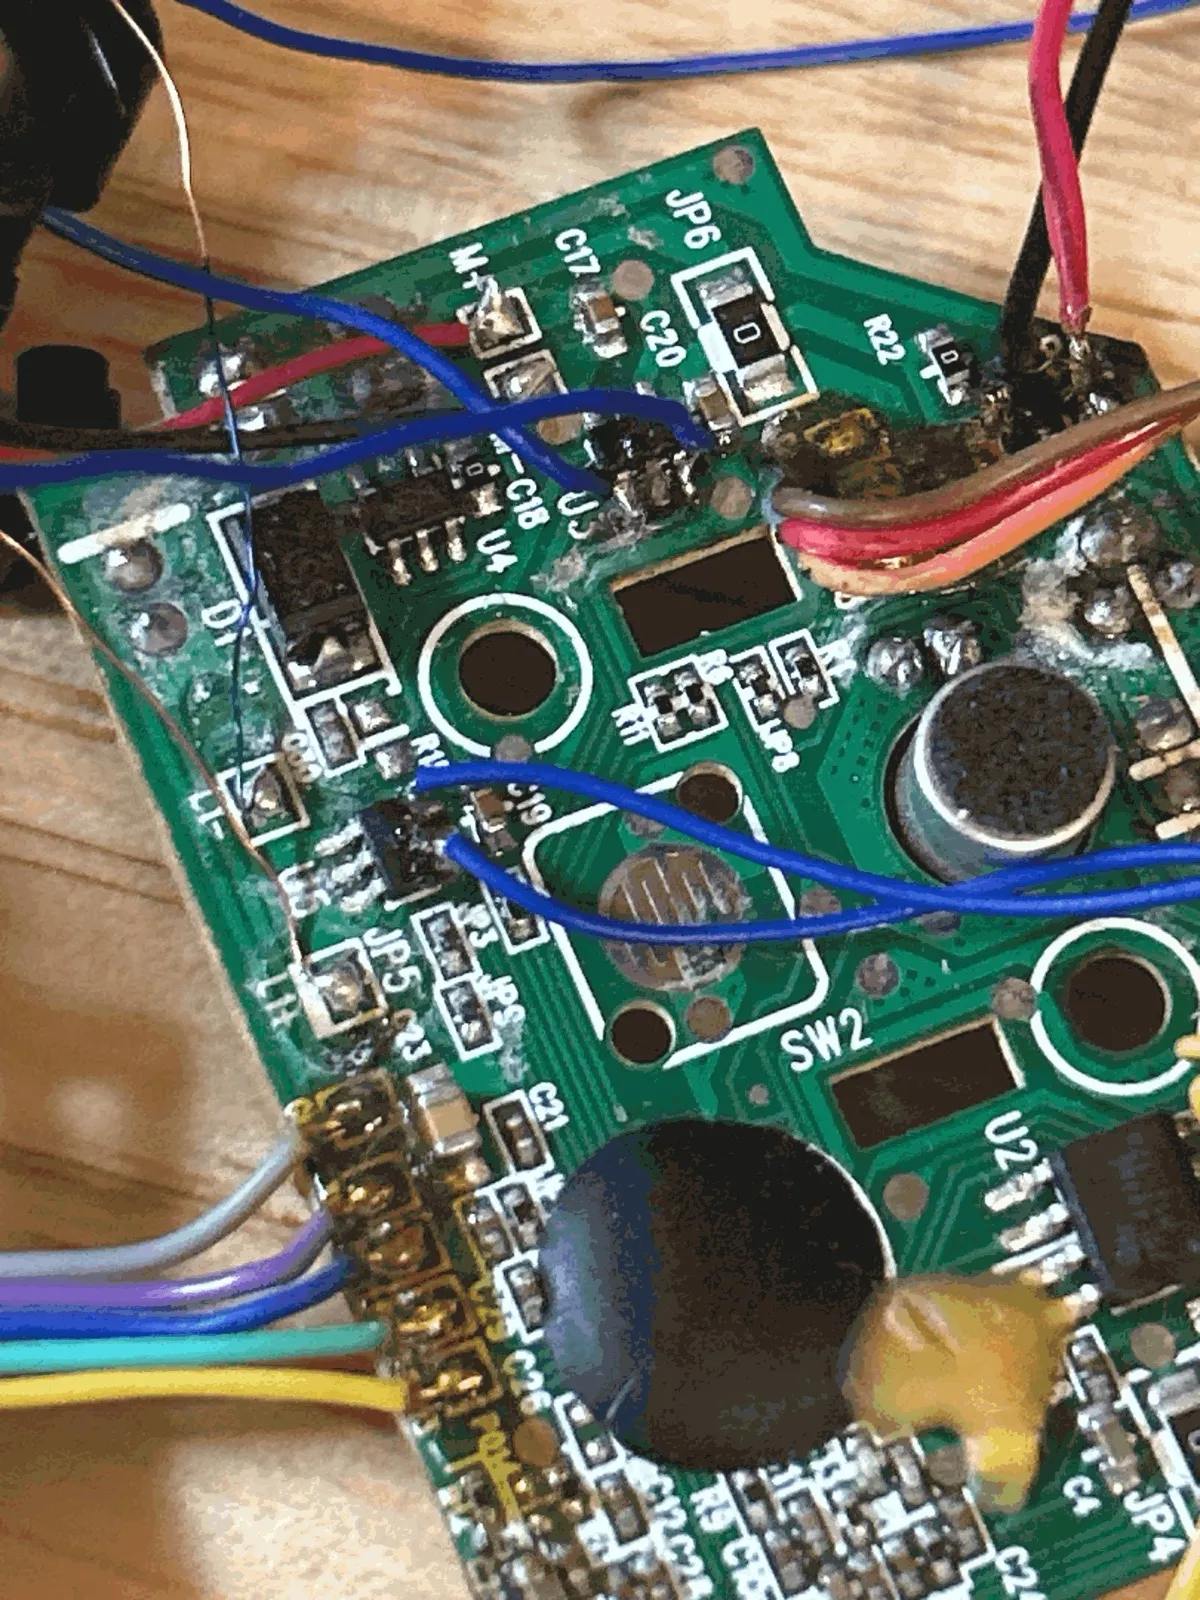
再接 U5,转向也有了。这里有一句一定要写在前面的警告:转向那两根线必须焊到 U5 的输入脚上,绝对不能直接接线圈,否则会烧掉 FT232H 的引脚。 U5 是 SOT-23-6 封装,六个脚里排除电源、地和线圈两端,剩下的两个才是输入。
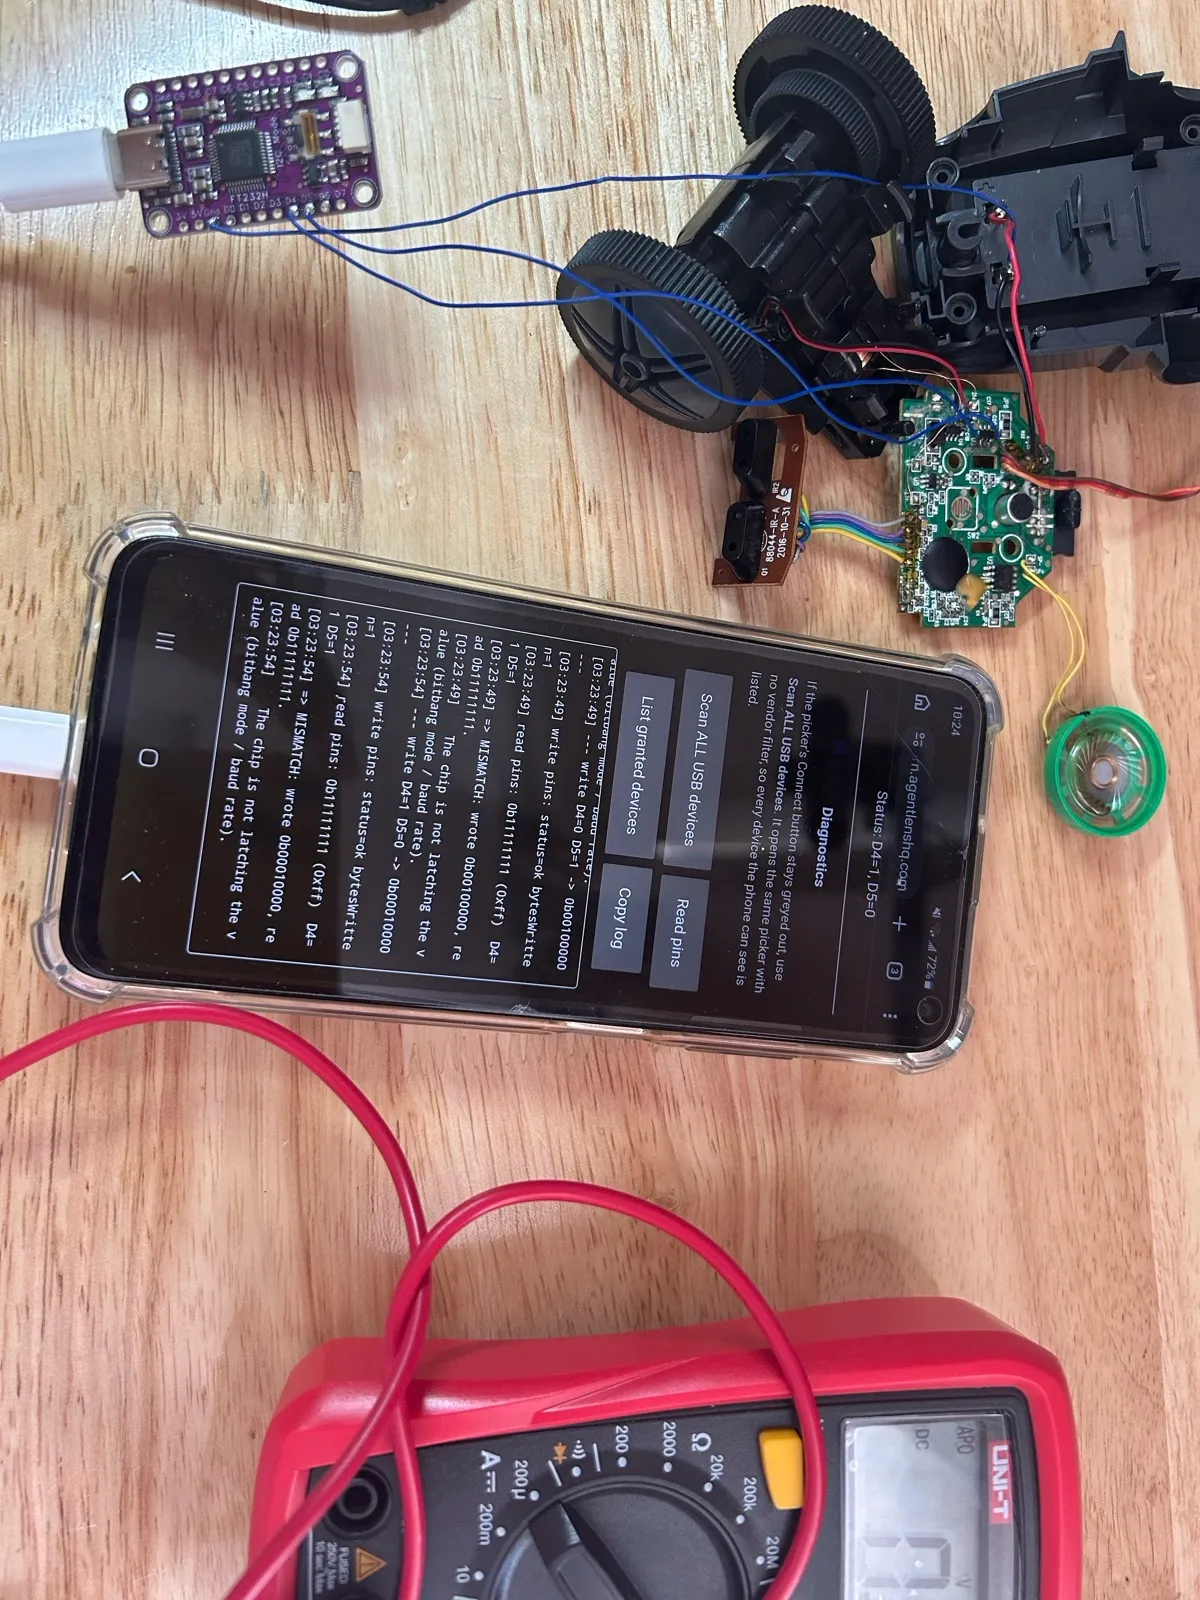
这是那几天桌上的样子:手机开着调试页,插着 FT232H,FT232H 连着拆成几块的机器人,旁边一台万用表。WebUSB 只有安卓上的 Chrome 有,iPhone 没有,所以大脑只能是一部安卓手机。
四、一个 bug,修了两次
车终于能动了,但动起来不对劲。我让它右转 600 毫秒,它只是抽搐一下,短到根本看不出往哪边转。
原因藏在一个很不起眼的假设里。FT232H 在这种模式下是「每个时钟节拍吐一个字节」,而代码一开始以为是「每个节拍吐一位」,于是所有时长都算短了 8 倍。我修了它,掐着秒表测了一次,大约 2 秒,跟预测差不多,就以为好了。
并没有好。 一天后换成芯片自己回读引脚来计时,真实速率又是我以为的 5 倍:这颗芯片的时钟是 60 MHz,而代码照着开源库按 12 MHz 在算,60 除以 12,正好是 5。所以之前「600 毫秒」的转弯,实际只开了 120 毫秒。
为什么秒表没发现?因为真实动作只有半秒,人手掐表大半是反应时间,电机停了还会惯性转一会儿,而秒表给出的数字又刚好和代码的预期对上。一个跟你预期一致的测量,最不容易被怀疑。 后来我把测量工具改成记录完整的引脚轨迹,读数从此可以拿出来争论,而不是凭手感。
五、给它装上耳朵、脑子和嘴
硬件通了,剩下的是软件。整条链路其实就一句话:
你说话 → 语音转文字 → 大模型决定做什么 → 开车 / 说话
- 耳朵:Groq 上的 Whisper 做语音转文字。价格大约每小时音频 4 美分,玩一个下午也花不了几毛钱。
- 脑子:DeepSeek。它可以调用几个工具:往前开几秒、转弯、停、播放一个声音。
- 嘴:云端 TTS,用网页的 WebAudio 播出来。
本来我打算用 Picovoice 做唤醒词,结果刚动手就发现它的免费额度在 2026 年 6 月底停了,付费版每月 6000 美元起。最后换成开源的 sherpa-onnx,自己编译成 WebAssembly 跑在手机浏览器里。那个文件 8 MB,第一次加载慢,之后就缓存住了。
还有个小坑:DeepSeek 新版默认会先「思考」再回答,每一句话都要先等它想完,机器人才开口。对一个要被小孩喊来喊去的机器人来说,这几秒太长了。关掉思考,它一下子就变机灵了。
一切都跑在一个网页里,没有服务器。密钥只存在手机上,直接发给你选的服务商。
这是我和 Mario 分岔最大的地方。他那边,手机只是个「傻终端」:负责收音、放音、拍照、通过 USB 开车,真正的大脑是笔记本上的一个服务器,听、想、说和他基于 pi 写的 agent 全在上面,用的都是本地模型(Parakeet 听,Gemma 想,Qwen3 TTS 说)。
我这边,大脑就是手机浏览器里的那个网页。唤醒词和「有没有人在说话」的判断在手机本地跑;听、想、说这三件重活交给云端 API,由网页直接去调;决定下一步做什么的那个循环,也在网页里。
第一版用云 API 有两个原因。一是快:先让它动起来,隐私和本地模型留到下一版。二是门槛:不是每个想做一台的人家里都有一台跑得动模型的电脑,而一部旧安卓手机,几乎人人都有。
六、熄屏 60 秒,它就聋了
做到这里出现了一个诡异的问题:手机一熄屏,大约 60 秒后,机器人就再也听不见了。
更诡异的是,我第一次测的时候它根本没聋,熄屏 5 分钟照样在听。后来才想明白:那次手机通过无线调试连着电脑,是调试连接把手机撑醒的。我为了绕开部署问题加的那条调试连接,恰恰改变了我要测的东西。断开之后,三次复现,59、60、65 秒,麦克风准时被安卓收走。
我先想了个歪招:熄屏时播一段极轻的「呼吸声」,220 Hz,4 秒一起伏,让 Chrome 以为自己在放音乐,就不会收麦克风。它确实管用,熄屏 5 分钟全程在听。
但后来我把它删了。这种招靠的是系统的一个行为,不是承诺,哪天安卓一更新就可能悄悄失效。最后换了个更诚实的规则:屏幕就是它的眼睛。 亮着,它就在听,连唤醒词都不需要;熄了,它就停车、闭耳朵。手机本来就是它的脸,这个规则小孩一看就懂。
七、砍掉脑袋,换上一张脸
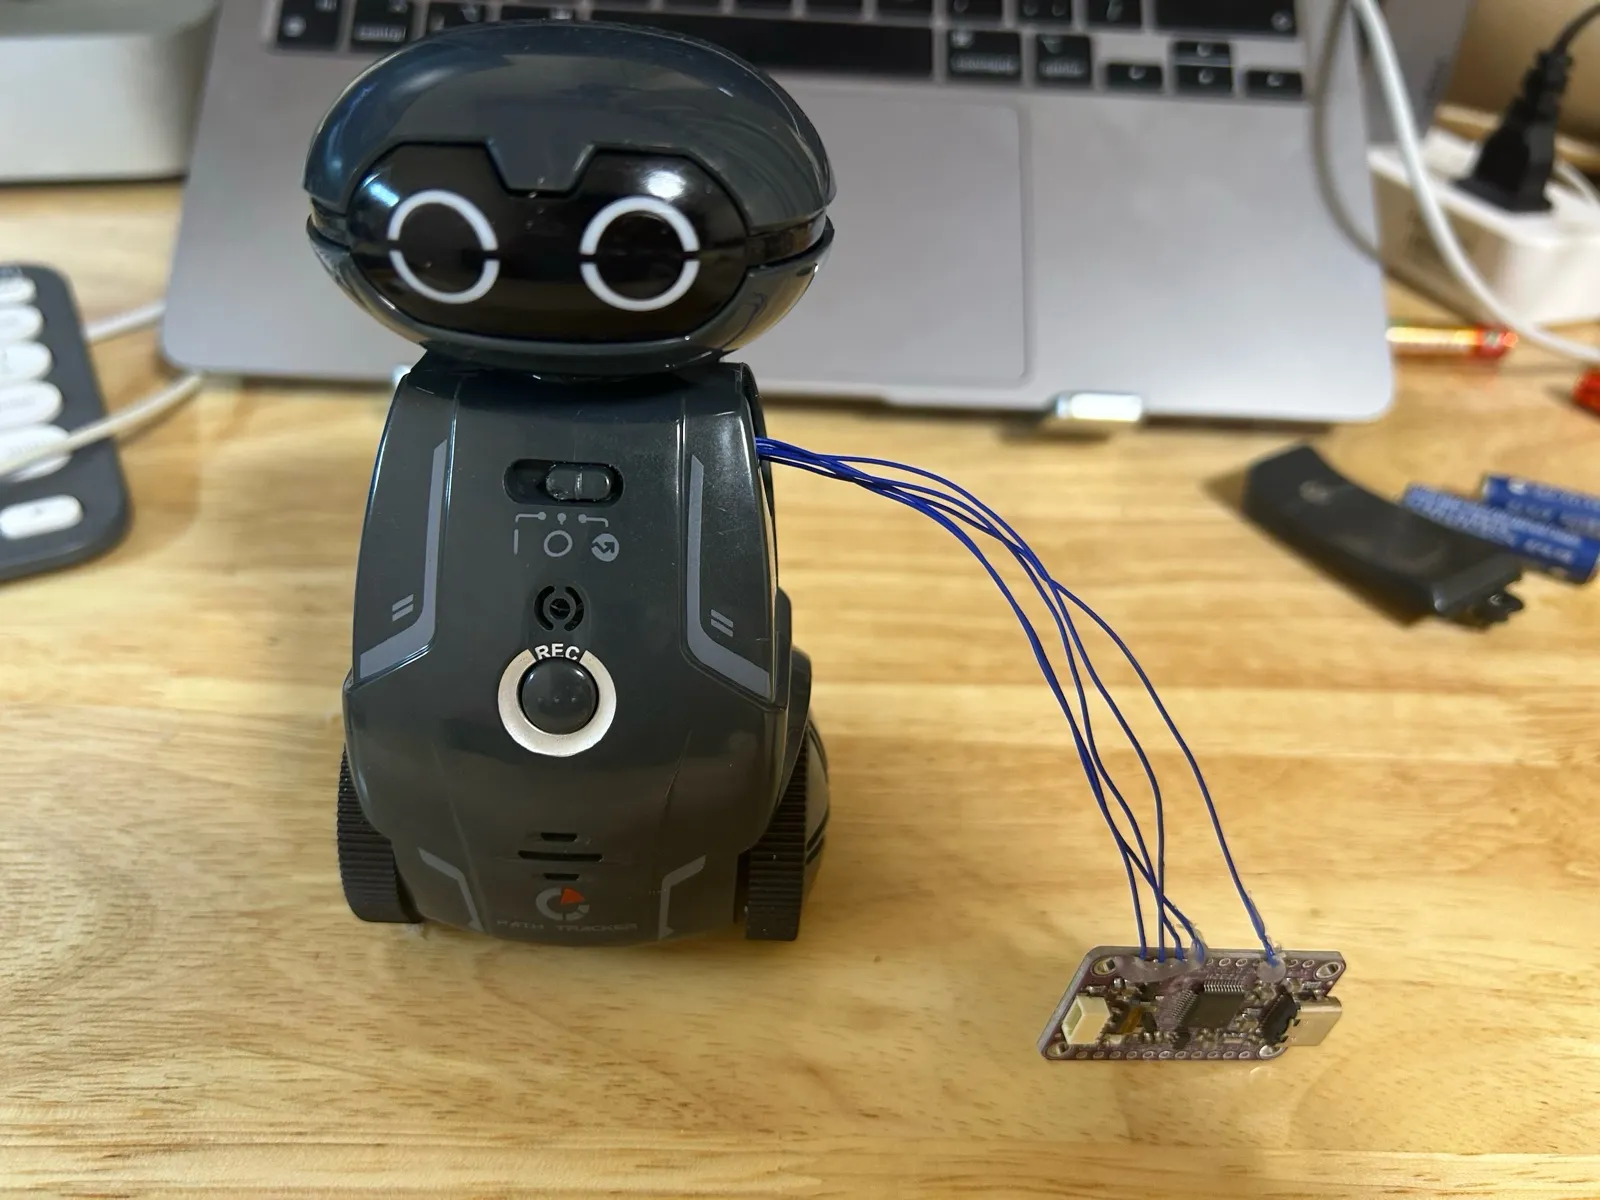
一开始,机器人还留着原来的头,手机放在旁边,FT232H 拖在身体外面。后来我觉得手机应该「骑」在车上,它的屏幕才是这台机器人真正的脸。问题是头挡着,手机放不上去。
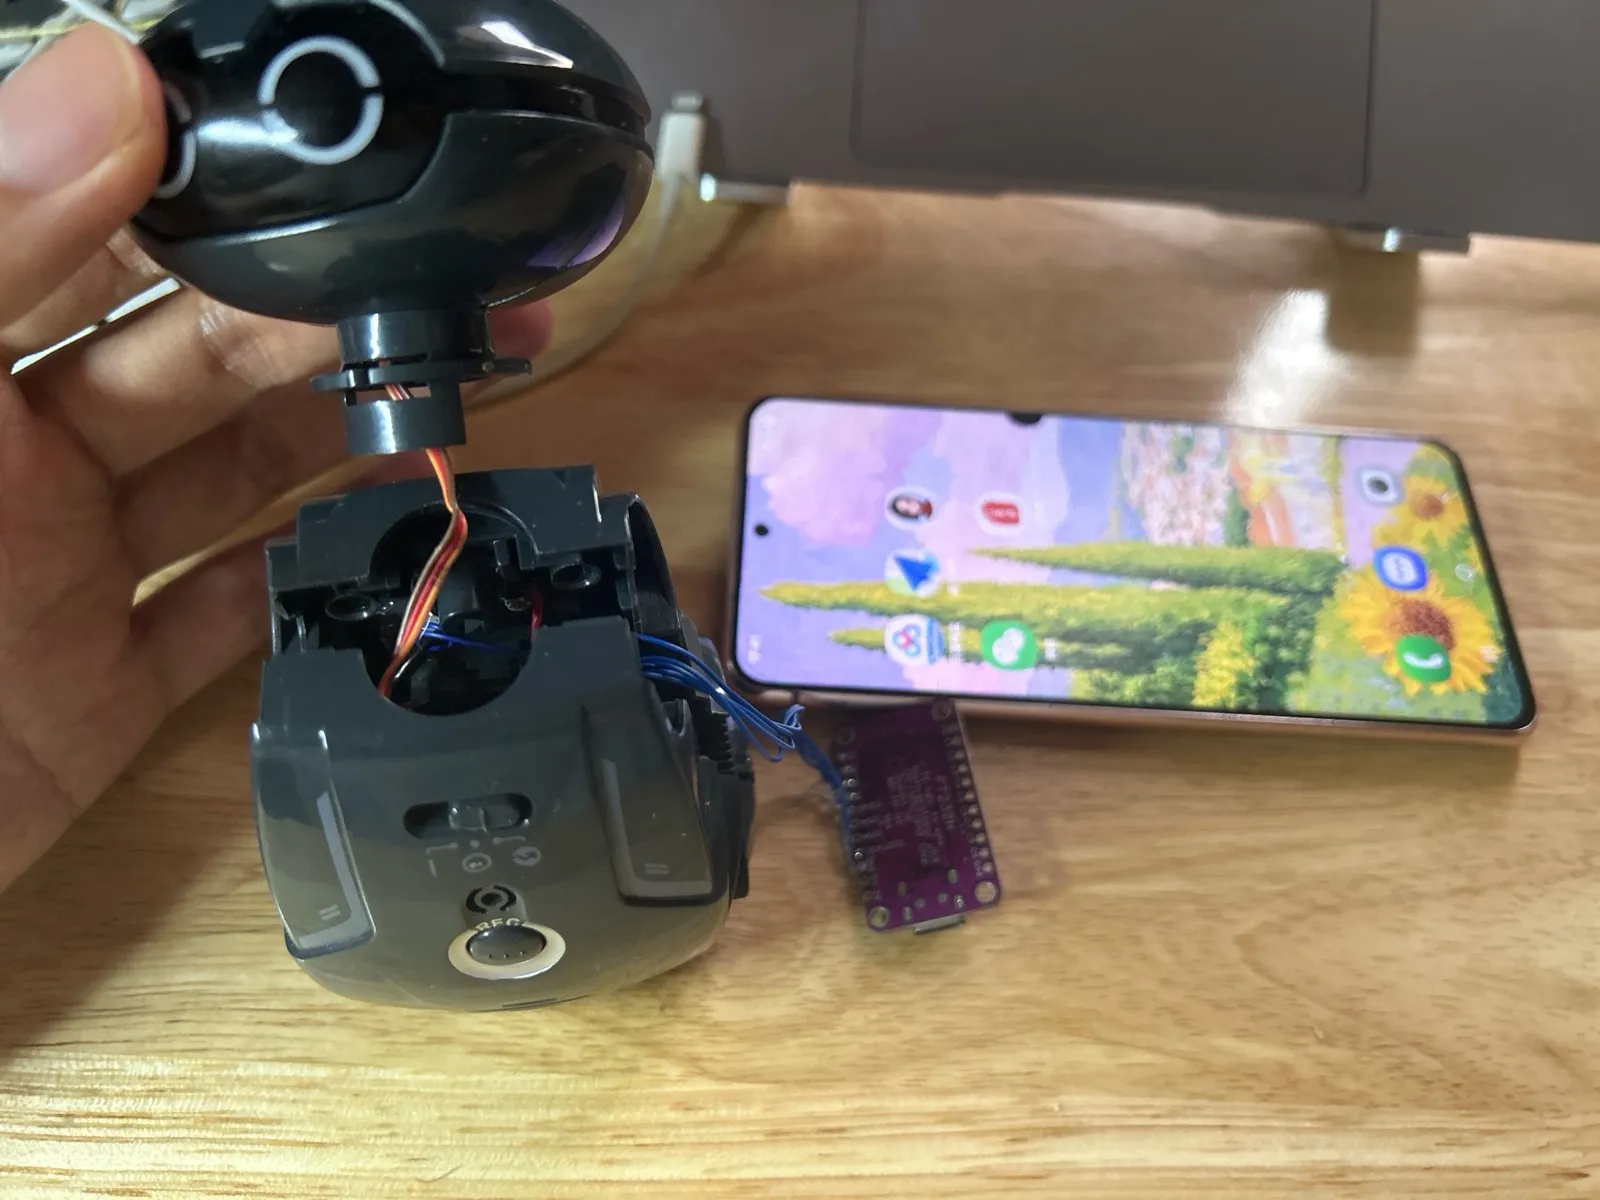
于是头没了。
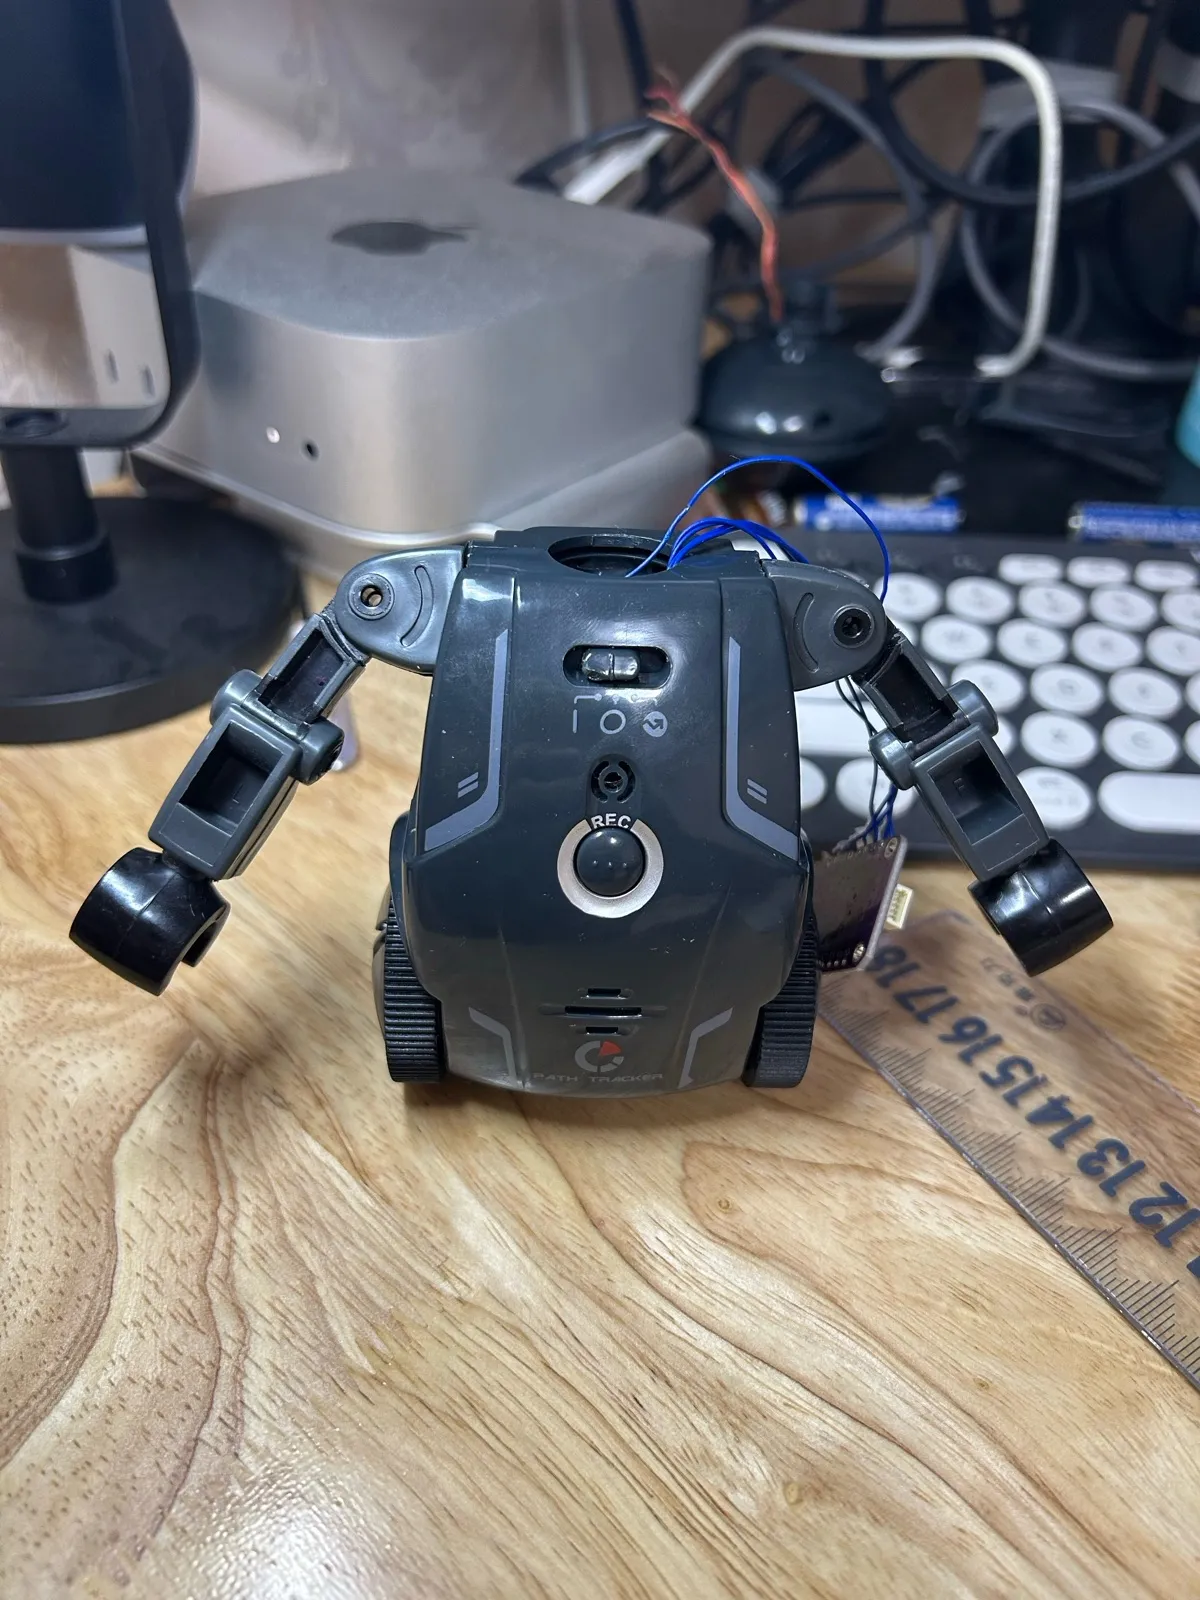
去掉头之后,顶上只剩一个拆不掉的脖子凹孔和两个肩关节。
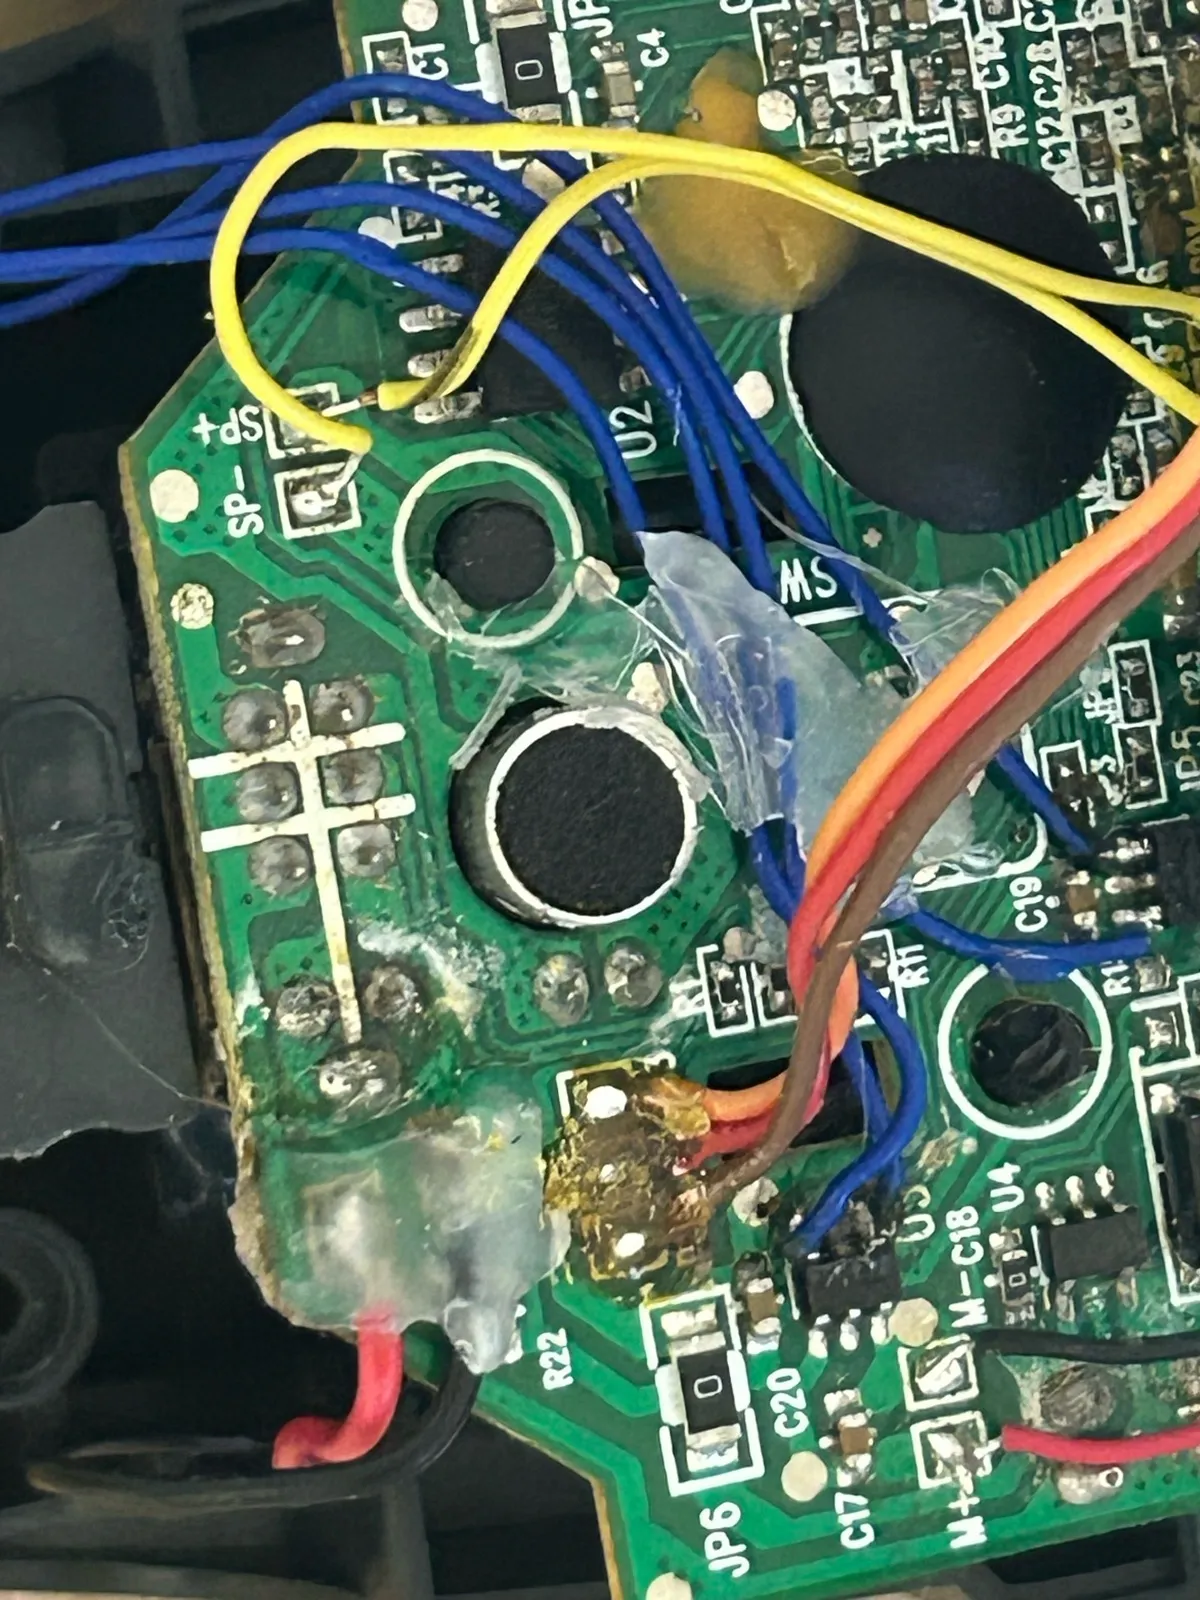
中间还有个插曲:板子左下角那根电源线,在制作过程中被拉断了三次。第三次之后我学乖了,在电源焊点那里糊上一大坨热熔胶,之后就再没断过。
托架用纸板做。动手之前,我先拿尺子量了身体:高 85 毫米,上窄下宽,前后左右都是斜的。然后和 Claude 一起画了一套设计图:前腿挖成两根叉,把开关和 REC 按钮露出来;顶上叠三层垫高块,让手机高过肩膀;再塞一根垫条,让手机往后仰 12 度。
真动手的时候,我把这些都砍了。REC 按钮对我没用,不用露出来;垫高块没必要,而且手机一垫高,重心就跟着抬高,车一动就晃;垫条也就跟着省了。设计图只当参考,实际做出来的简单得多:
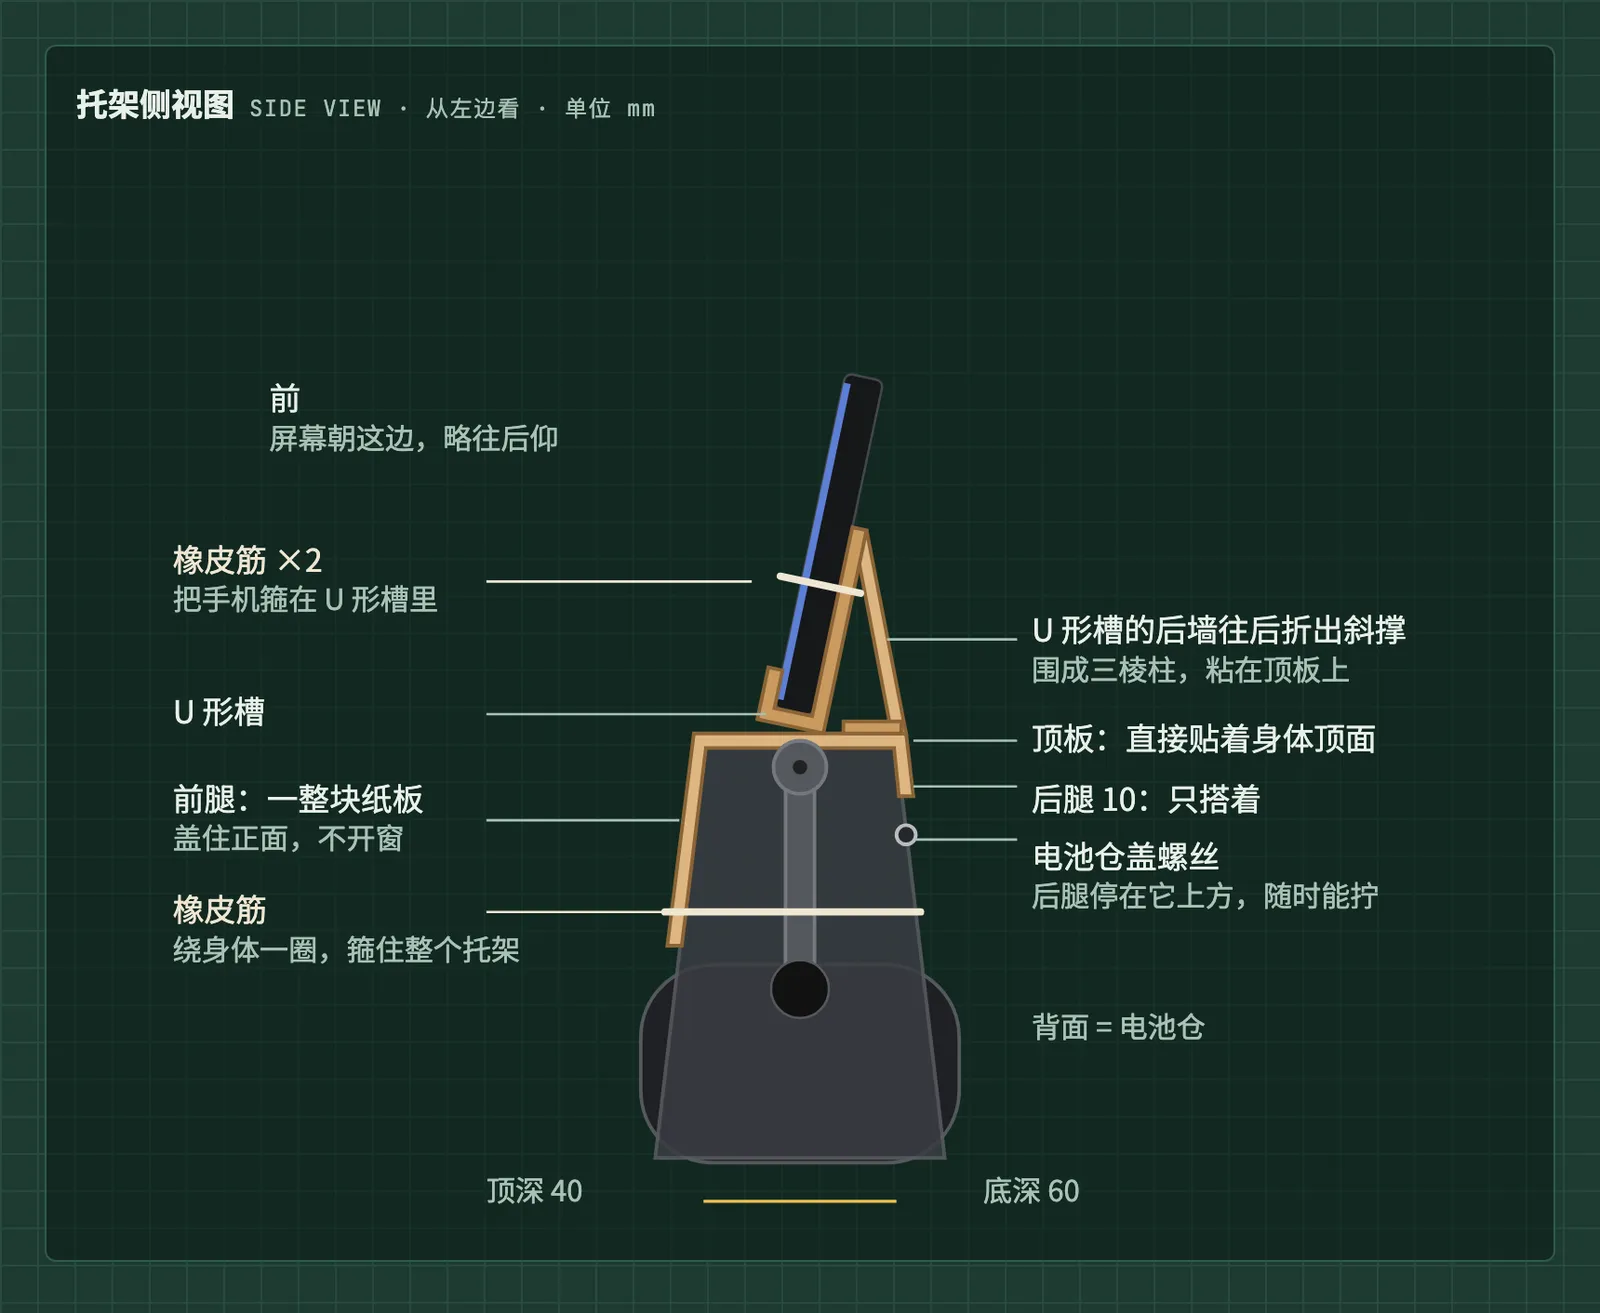
一块纸板前后跨在身体上,前腿整块盖住正面,后腿短短地搭在背面,停在电池仓螺丝的上方,换电池不用拆托架。顶上粘一个 U 形槽,后墙往后折出一根斜撑,围成三棱柱,手机就斜靠在上面,略往后仰。固定全靠橡皮筋:一根绕身体一圈箍住托架,两根把手机箍在槽里。
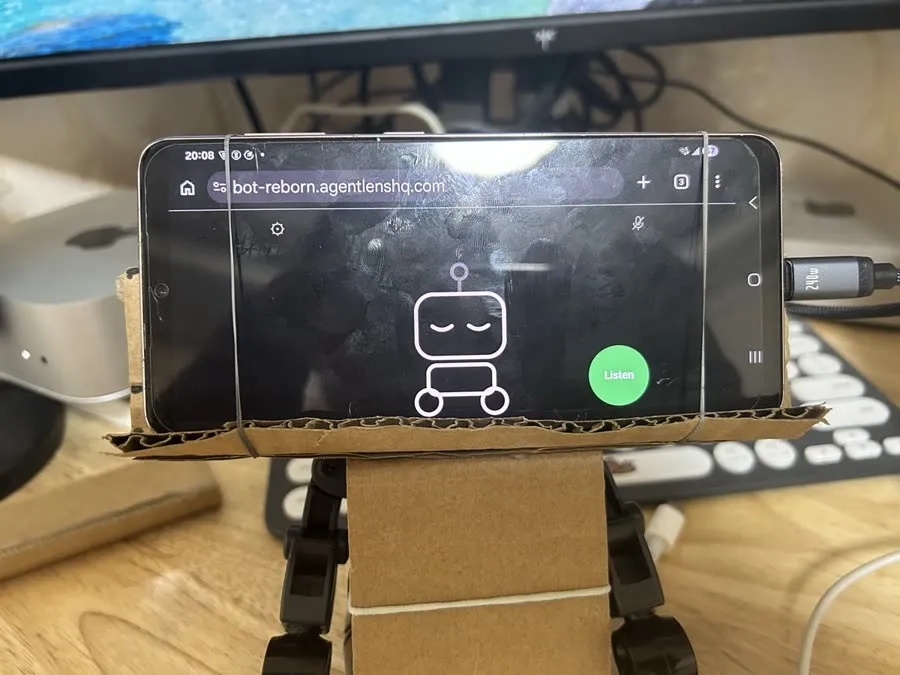
这是做出来的样子。
手机横着放,屏幕上就是机器人的脸。为了让它全屏、横屏、没有地址栏,我把网页做成了可以「添加到主屏幕」的应用。它有五种表情:睡着、在听、听到你说话了、在想、在说。
八、它是个机器,所以不会被逗
接下来发生了这个项目里我最喜欢的一件事。
孩子很快发现,对着机器人学狗叫很好玩。可机器人每次都一本正经地回一句话,然后原地不动。
问题出在两个地方。第一,系统提示词的第一句是「你是一个小机器人」,而机器人是不会被逗的。 第二,提示词里有一条「如果用户只是在闲聊,不要调用工具」,这直接禁掉了它唯一能表现情绪的方式:动。
我把它改成了「一个有脾气的小生物」,允许聊天以一个动作结尾。
然后第二个问题来了:Whisper 把狗叫「汪汪」听成了「忘忘」,有时候是「Wong Wong」,猫叫变成「Miau Miau」。模型收到一句「忘忘」,完全不知道刚才有人冲它叫。
我先试了在语音识别的提示词里写上「汪汪」「喵喵」,确实管用。但没多久又拿掉了:一句写死的提示词只照顾得到一个用户。现在语音识别默认不带任何提示词,「忘忘」这种同音字交给后面的反射层去认。
孩子那边倒是自己找到了办法:改用英文的「woof」冲它叫。
最后我干脆给它加了个反射层,用的是 JEV。
JEV 是 TypeSafe 出的一个模型,最近几周才火起来,我一看就觉得正好用得上。它跟聊天模型不一样:不生成文字,只做判断。你给它一段情况、一道选择题,它告诉你每个选项的概率。
我给它出的题是「这个人在干什么」,三个选项:学动物叫、下指令、正常回话。题目里还附上机器人刚说过的上一句,并提醒它:「汪汪」可能被写成「忘忘」「往往」,猫叫可能被写成「苗苗」;但「明白」「好的」「嗯嗯」这种短回答,永远算正常回话。
只有「学动物叫」的概率到 0.8 以上才算数。一旦算数,就不问大模型了,直接按一个固定套路反应:
- 叫回去;
- 再被叫,叫一声,掉头跑;
- 还叫,呜咽一声,往后退。
这跟人被吓到时差不多:先反应,后思考。
比起全交给大模型,这样有三个好处。一是快:被叫的时候不用等大模型想完、再等语音合成念完,一个音效加一个动作就是回答。二是省:一声「汪汪」不值得一次大模型调用。三是准:大模型看到「忘忘」只会按字面理解,而 JEV 拿到的题目里就写着「这可能是狗叫」。
定规矩的时候,我最怕的不是漏判,而是误判。漏判了,大不了交给大模型兜底;误判了,孩子认认真真回答的一句「明白」,就被当成狗叫吞掉了。所以阈值定得偏高,而且只有短句才去问 JEV:中文不超过 6 个字,英文不超过 3 个词。长句不像狗叫,也不值得多等。移动指令也不归它管:带参数的指令大模型做得更好,最急的那声「停」,本地有急停词。
九、它是怎么开始的,现在又怎么样了
从拆开到它第一次完整跑通,大概一个月。这期间几乎每一行代码都是我和 Claude 一起写的:我负责拆、焊、测、拍板,它负责把想法变成代码,再一起把测出来的问题修掉。
我录了一段 17 秒的视频:机器人在地上陪孩子玩;旁边那只真狗全程埋头吃饭,只看了一眼。标题就叫「真狗:忙着吃饭。机器狗:正在值班。」(在 YouTube 上看)
后来它又多了一份工作:孩子写作业的时候,它在桌上回答科学问题,偶尔还带点脾气。(在 YouTube 上看)
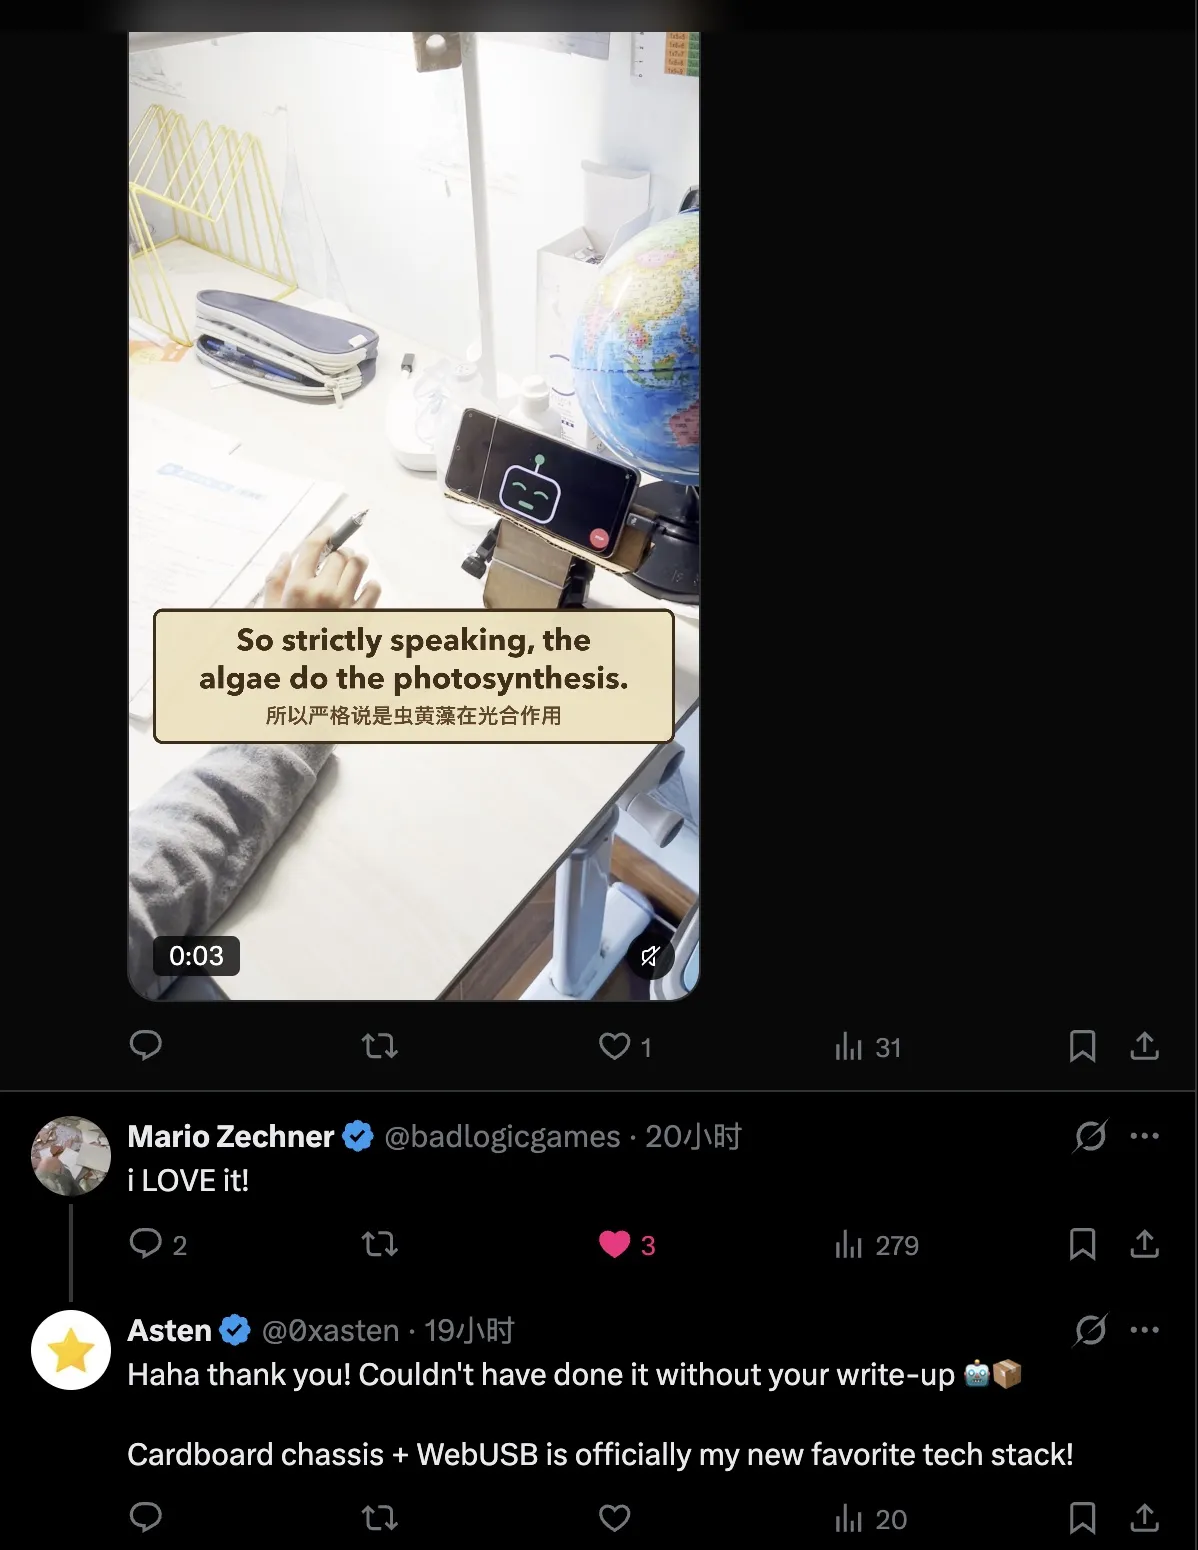
我把这段视频发到推特上,@ 了 Mario。他回了一句「i LOVE it!」,还转发了。一个月前我还在读他的文章,一个月后他在看我的机器人。
谢谢 Mario。没有他那篇文章,就不会有这台机器人。他给了我灵感,也把最难探的那段路先走通了:手机当大脑、FT232H、WebUSB,我都是照着他的路线走的,省下了大把摸索的时间。我写这篇,也是希望它能像他那篇帮到我一样,帮到下一个想给孩子 DIY 一台陪伴机器人的人。
现在,孩子会自己去探索它的玩法,最喜欢的还是跟它聊天。
做的过程中我最意外的是,好点子很多不是我想出来的,是孩子玩出来的。冲它学狗叫,是孩子先发现的乐子,这才有了「有脾气的小生物」和反射层;汪汪被听成「忘忘」,孩子转头就改用「woof」。孩子每一次的反应都是最及时的反馈,告诉我下一步该改什么。
这台机器人还远没做完,但它已经在陪孩子玩、陪孩子聊天了。这就是我当初想要的。
想自己做一台?
代码以 MIT 协议开源在 github.com/beasaltfish/bot-reborn。你需要:
- 一台带电机和转向的便宜玩具车或机器人;
- 一块 FT232H 小板子;
- 一部安卓手机(Chrome)和一根 USB-C 线;
- 语音转文字、大模型、语音合成三家服务的 API key,兼容 OpenAI 接口的都行;
- 烙铁、几根线、纸板、橡皮筋,最好再来一把热熔胶枪。
不用自己部署,手机 Chrome 打开 bot-reborn.agentlenshq.com 就能用。机器人会告诉你它还缺什么:密钥、插上板子,然后教它哪边是左。接线和引脚表在仓库的 docs/hardware.md 里,焊转向那两根线之前,先读那段警告。