vLLM 分层 KV 缓存卸载
TL;DR
vLLM 添加了分层 KV 缓存卸载功能,将被驱逐的键值(KV)数据保留在主机内存、文件系统、对象存储或对等节点中,从而消除昂贵的重新计算,降低延迟,并提升 LLM 集群的有效服务容量。
以主机为中心的设计确保快速内存释放和集中 I/O
该框架在 KV 数据到达任何二级层级之前,将其全部路由至主机内存(CPU DRAM)。卸载过程通过 PCIe 将 KV 块从加速器复制到主机,立即释放加速器内存,然后异步将数据写入二级层级(文件系统、对象存储或对等节点)。重新加载则反向进行:二级层级将块提升回主机内存,之后加速器接收该数据。这种按需分配模式确保加速器内存仅在实际需要时才被占用。
将多个 GPU 的分片集中到一个共享主机区域,减少了 I/O 操作次数,提升了多加速器环境下的存储和网络吞吐量。
主机区域采用标准内存布局——每个页存储一个层的一个块,所有张量并行分片的 KV 头连续聚集。由于布局与配置无关,具有不同并行设置或注意力后端的节点可以无需转换地共享 KV 数据。
将所有数据通过主机路由也使二级层级的实现变得简单:它们作为每个 vLLM 实例的单一进程运行,使用标准的基于 CPU 的库(POSIX I/O、S3 SDKs、RDMA 语句),且从不接触加速器内存。
卸载和重新加载机制基于固定大小的块
KV 数据被划分为块,每个块覆盖一组标记。默认情况下,一个块对应一个加速器块;blocks_per_chunk 参数可增大块大小以提高 I/O 粒度。
卸载路径
- 异步通过 DMA 将 KV 块从加速器传输到主机。
- 一旦主机副本完成,立即释放加速器内存。
- 分层管理器同时将主机副本推送到所有配置的二级层级。
- 主机层级充当 LRU/ARC 缓存;块在主机内存中保留,直到容量超限,然后仅被驱逐到二级层级。
重新加载路径
- 调度器检查主机缓存;命中则立即返回块。
- 主机未命中时,按顺序查询二级层级;第一个拥有该块的层级提供数据。
- 该层级异步将块提升回主机内存;调度器收到
RETRY,在下一周期重新检查。 - 同一请求的不同块可能由不同层级满足(例如,一个来自文件系统,另一个来自远程对等节点)。
支持的二级层级
文件系统层级
- 使用内容寻址命名,将每个 KV 块作为文件存储在本地或网络存储中。
- 多个 vLLM 实例挂载同一目录时可自动共享。
- 非阻塞查找、原子写入、独立的读/写线程池。
vllm serve Qwen/Qwen3.6-35B-A3B \
    --kv-transfer-config '{
        "kv_connector_extra_config": {
            "spec_name": "TieringOffloadingSpec",
            "cpu_bytes_to_use": 107374182400,
            "secondary_tiers": [{"type": "fs", "root_dir": "/mnt/kv-cache"}]
        }
    }'
对象存储层级
- 通过 NIXL 将块持久化到 S3 兼容存储,使用相同的基于内容的寻址方案。
- 提供一种成本效益高、跨网络的缓存。
--kv-transfer-config '{
    "kv_connector_extra_config": {
        "spec_name": "TieringOffloadingSpec",
        "cpu_bytes_to_use": 107374182400,
        "secondary_tiers": [{
            "type": "obj",
            "bucket": "my-kv-cache",
            "endpoint_override": "http://minio:9000"
        }]
    }
}'
点对点(P2P)层级
- 通过 ZMQ 协调、RDMA 执行批量传输,在网络上实现跨实例 KV 共享。
- 所有传输均为主机到主机;不涉及加速器内存。
- 协调系统(如 llm-d)决定从哪个对等节点拉取。
--kv-transfer-config '{
    "kv_connector_extra_config": {
        "spec_name": "TieringOffloadingSpec",
        "cpu_bytes_to_use": 107374182400,
        "secondary_tiers": [{"type": "p2p", "host": "10.0.0.1", "port": 5710}]
    }
}'
关键 P2P 使用场景
- 预填充/解码分离:预填充节点将 KV 块写入其主机层级;解码节点通过 RDMA 拉取,实现计算与数据移动的重叠。
- 负载均衡:过载实例可将块卸载到利用率较低的对等节点,提升整体吞吐量。
混合模型兼容性
分层卸载框架与 vLLM 的混合内存分配器集成,将所有 KV 格式(完整注意力、滑动窗口、MLA、Mamba 等)统一为统一的字节缓冲表示。每个块在主机上具有固定的字节大小,与层类型无关,从而在异构架构间实现一致的卸载。因此:
- 滑动窗口层仅重新加载活跃窗口的标记。
- 状态空间层(如 Mamba)与其注意力 KV 一起卸载和重新加载其内部状态。 支持的混合模型包括 DeepSeek V4、GLM 5.3、Nemotron 3 等。
可观测性与指标
vLLM 在标准 /metrics 端点暴露 Prometheus 指标,涵盖:
- 主机缓存利用率(填充率)。
- 加速器↔主机传输吞吐量。
- 各层级的查找和传输延迟。
- 各层级的命中率。 二级层级可注册自定义计数器、直方图或仪表,这些指标会自动暴露。
KV 事件支持智能编排
每当块在层级间移动时,框架会发出结构化的 KV 事件,包含块键、源层级、目标层级和本地性(本地 vs. 远程)。编排系统如 llm-d 和 Dynamo 消费这些事件,将请求路由到最可能命中缓存的实例,并触发 P2P 传输,相比无缓存感知的调度,可实现更高的吞吐量和更低的延迟。
通过新二级层级扩展系统
二级层级需实现四个方法:
class SecondaryTierManager(ABC):
    def lookup(self, key, req_context) -> LookupResult: ...
    def submit_store(self, job_metadata: JobMetadata) -> None: ...
    def submit_load(self, job_metadata: JobMetadata) -> None: ...
    def get_finished_jobs(self) -> Iterable[JobResult]: ...
管理器接收对共享主机区域的直接 memoryview,支持零拷贝读写。每个层级独立管理驱逐策略。内存中参考实现位于 vllm/v1/kv_offload/tiering/example/。可通过在层级配置中指定 module_path 加载树外层级。
规模化性能:卸载优于重新计算
在 2 × NVIDIA H100(TP=2)上对 Qwen 3.6‑35B‑A3B 的基准测试显示:
- 最多约 64 个并发对话:加速器内存可容纳整个工作集;所有缓存策略表现相似。
- 64–128 个对话:加速器内存饱和;无卸载时吞吐量崩溃,而 CPU 卸载维持性能。
128 个对话:CPU 缓存也已填满;基于存储的卸载保持高命中率,吞吐量比完全重新计算高出两倍以上。
所用存储层级为本地 NVMe 文件系统。尽管存储延迟高于 CPU 内存,但来自存储的缓存命中仍远比重新预填充模型便宜。
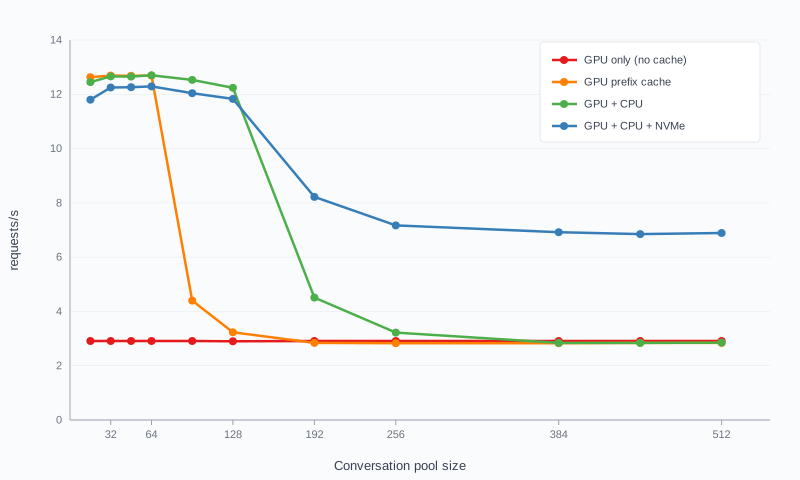
完整基准脚本和结果托管于 neuralmagic/fs-offload-experiments。
致谢
感谢 Liran Schour、Chang Guo、Srinivas Krovvidi、Rotem Shavitt、Effi Ofer、Omer Paz、Kfir Toledo、Michal Malka 以及更广泛的社区对分层 KV 缓存卸载框架的贡献。