vLLM 계층적 KV 캐시 오프로딩
TL;DR
vLLM은 계층적 KV 캐시 오프로딩을 추가하여, 제거된 키-값(KV) 데이터를 호스트 메모리, 파일 시스템, 객체 스토리지 또는 피어 노드에 유지함으로써 비용이 큰 재계산을 제거하고 지연을 줄이며 LLM 클러스터의 효과적인 서비스 용량을 증가시켰습니다.
호스트 중심 설계는 빠른 메모리 해제와 통합된 I/O를 보장합니다
프레임워크는 모든 KV 데이터가 2차 계층에 도달하기 전에 모든 KV 데이터를 호스트 메모리(CPU DRAM)를 통해 전달합니다. 오프로딩은 PCIe를 통해 가속기에서 호스트로 KV 조각을 비동기 DMA로 복사하고, 가속기 메모리를 즉시 해제한 후, 비동기적으로 데이터를 2차 계층(파일 시스템, 객체 스토리지, 또는 피어)에 씁니다. 재로딩은 반대 흐름을 따릅니다: 2차 계층이 조각을 호스트 메모리로 승격한 후, 가속기가 이를 수신합니다. 이 즉시 할당 패턴은 가속기 메모리가 실제로 필요할 때만 점유되도록 보장합니다.
다수의 GPU에서 발생하는 조각들을 단일 공유 호스트 영역으로 통합하면 I/O 작업 수가 감소하여 다중 가속기 환경에서 저장소 및 네트워크 대역폭이 향상됩니다.
호스트 영역은 표준 메모리 레이아웃을 사용합니다—각 페이지는 하나의 레이어의 하나의 블록을 저장하며, 텐서 병렬 랭크들에서 온 모든 KV 헤드가 연속적으로 모여 있습니다. 레이아웃이 구성에 독립적이므로, 병렬 처리 설정이나 어텐션 백엔드가 다른 노드들이 KV 데이터를 변환 없이 공유할 수 있습니다.
모든 데이터를 호스트를 통해 라우팅함으로써 2차 계층의 구현이 간단해집니다: 각 vLLM 인스턴스당 단일 프로세스로 작동하며, 표준 CPU 기반 라이브러리(POSIX I/O, S3 SDKs, RDMA verbs)를 사용하고, 가속기 메모리에 접근하지 않습니다.
오프로드 및 재로드 메커니즘은 고정 크기 조각을 기반으로 작동합니다
KV 데이터는 조각으로 나뉘며, 각 조각은 일정 수의 토큰을 커버합니다. 기본적으로 조각은 하나의 가속기 블록에 매핑되며, blocks_per_chunk 매개변수를 통해 조각 크기를 늘려 I/O의 세분화를 높일 수 있습니다.
오프로드 경로
- 가속기에서 호스트로 KV 조각을 비동기적으로 DMA로 복사합니다.
- 호스트 복사본이 완료되면 가속기 메모리를 즉시 해제합니다.
- 계층 관리자가 동시에 호스트 복사본을 모든 구성된 2차 계층에 전달합니다.
- 호스트 계층은 LRU/ARC 캐시로 작동하며, 용량이 초과될 때까지 조각이 호스트 메모리에 머무릅니다. 이후 조각은 오직 2차 계층으로 제거됩니다.
재로드 경로
- 스케줄러가 호스트 캐시를 확인합니다. 캐시 히트 시 조각을 즉시 반환합니다.
- 호스트 미스 시, 2차 계층을 순서대로 쿼리합니다. 조각이 있는 첫 번째 계층이 조각을 제공합니다.
- 계층이 조각을 비동기적으로 호스트 메모리로 승격합니다. 스케줄러는
RETRY를 수신하고 다음 사이클에서 다시 확인합니다. - 동일한 요청의 서로 다른 조각은 서로 다른 계층에서 제공될 수 있습니다(예: 파일 시스템에서 하나, 원격 피어에서 다른 하나).
지원되는 2차 계층
파일 시스템 계층
- 각 KV 조각을 로컬 또는 네트워크 기반 스토리지에 콘텐츠 기반 이름으로 파일로 저장합니다.
- 여러 vLLM 인스턴스가 동일한 디렉터리를 마운트하면 자동으로 공유됩니다.
- 비차단 검색, 원자적 쓰기, 별도의 읽기/쓰기 스레드 풀을 제공합니다.
vllm serve Qwen/Qwen3.6-35B-A3B \
    --kv-transfer-config '{
        "kv_connector_extra_config": {
            "spec_name": "TieringOffloadingSpec",
            "cpu_bytes_to_use": 107374182400,
            "secondary_tiers": [{"type": "fs", "root_dir": "/mnt/kv-cache"}]
        }
    }'
객체 스토리지 계층
- NIXL을 사용하여 S3 호환 스토리지에 조각을 영구 저장하며, 동일한 콘텐츠 기반 이름 방식을 사용합니다.
- 비용 효율적이고 네트워크 전체에 걸쳐 캐시를 제공합니다.
--kv-transfer-config '{
    "kv_connector_extra_config": {
        "spec_name": "TieringOffloadingSpec",
        "cpu_bytes_to_use": 107374182400,
        "secondary_tiers": [{
            "type": "obj",
            "bucket": "my-kv-cache",
            "endpoint_override": "http://minio:9000"
        }]
    }
}'
피어 간(P2P) 계층
- ZMQ를 사용한 조정과 RDMA를 사용한 대량 전송을 통해 네트워크를 통해 인스턴스 간 KV 공유를 가능하게 합니다.
- 모든 전송은 호스트 간 전송이며, 가속기 메모리는 사용되지 않습니다.
- 조정(예: llm-d)은 어느 피어에서 가져올지 결정합니다.
--kv-transfer-config '{
    "kv_connector_extra_config": {
        "spec_name": "TieringOffloadingSpec",
        "cpu_bytes_to_use": 107374182400,
        "secondary_tiers": [{"type": "p2p", "host": "10.0.0.1", "port": 5710}]
    }
}'
핵심 P2P 사용 사례
- 프리필/디코딩 분리: 프리필 노드가 KV 조각을 자신의 호스트 계층에 씁니다. 디코딩 노드는 RDMA를 통해 이를 가져와 계산과 데이터 이동을 겹치게 합니다.
- 로드 밸런싱: 과부하된 인스턴스는 사용률이 낮은 피어에 조각을 오프로딩하여 전체 처리량을 향상시킵니다.
하이브리드 모델 호환성
계층적 오프로딩 프레임워크는 vLLM의 하이브리드 메모리 할당기와 통합되어, 모든 KV 형식(전체 어텐션, 슬라이딩 윈도우, MLA, Mamba 등)을 일관된 바이트 버퍼 표현으로 정규화합니다. 각 조각은 레이어 유형에 관계없이 호스트에서 고정된 바이트 크기를 가지며, 이는 이질적인 아키텍처 간 일관된 오프로딩을 가능하게 합니다. 따라서:
- 슬라이딩 윈도우 레이어는 활성 윈도우 토큰만 재로드합니다.
- 상태 공간 레이어(Mamba 등)는 어텐션 KV와 함께 내부 상태를 함께 오프로딩 및 재로드합니다. 지원되는 하이브리드 모델에는 DeepSeek V4, GLM 5.3, Nemotron 3 등이 포함됩니다.
관찰 가능성 및 메트릭
vLLM은 표준 /metrics 엔드포인트에서 Prometheus 메트릭을 노출하며, 다음을 포함합니다:
- 호스트 캐시 사용률(채움 비율).
- 가속기 ↔ 호스트 전송 대역폭.
- 계층별 조회 및 전송 지연.
- 계층별 캐시 히트율. 2차 계층은 자동으로 노출되는 사용자 정의 카운터, 히스토그램 또는 게이지 메트릭을 등록할 수 있습니다.
KV 이벤트는 지능적인 오케스트레이션을 가능하게 합니다
조각이 계층 간 이동할 때마다 프레임워크는 구조화된 KV 이벤트를 생성하여 조각 키, 소스 계층, 목적지 계층, 그리고 지역성(로컬 vs. 원격)을 나타냅니다. llm-d 및 Dynamo과 같은 오케스트레이션 시스템은 이러한 이벤트를 소비하여 캐시 히트 가능성이 가장 높은 인스턴스로 요청을 라우팅하고 P2P 전송을 트리거함으로써 캐시 무지한 스케줄링보다 더 높은 처리량과 낮은 지연을 달성합니다.
새로운 2차 계층으로 시스템 확장하기
2차 계층은 네 가지 메서드를 구현해야 합니다:
class SecondaryTierManager(ABC):
    def lookup(self, key, req_context) -> LookupResult: ...
    def submit_store(self, job_metadata: JobMetadata) -> None: ...
    def submit_load(self, job_metadata: JobMetadata) -> None: ...
    def get_finished_jobs(self) -> Iterable[JobResult]: ...
매니저는 공유 호스트 영역에 대한 직접 memoryview를 수신하여 0복사 읽기/쓰기를 가능하게 합니다. 제거 정책은 각 계층마다 독립적으로 관리됩니다. 메모리 내 참조 구현은 vllm/v1/kv_offload/tiering/example/에 제공됩니다. 트리 외부의 계층은 계층 구성에서 module_path를 지정하여 로드할 수 있습니다.
스케일링에서의 성능: 오프로딩은 재계산보다 낫습니다
2 × NVIDIA H100(TP=2)에서 Qwen 3.6‑35B‑A3B로 벤치마킹한 결과:
- 최대 약 64개의 동시 대화: 가속기 메모리가 전체 워킹 세트를 보유; 모든 캐싱 전략이 유사하게 작동.
- 64–128개의 대화: 가속기 메모리가 포화됨; 오프로딩 없이 처리량이 붕괴되지만, CPU 오프로딩은 성능을 유지.
- 128개 이상의 대화: CPU 캐시도 포화됨; 스토리지 기반 오프로딩은 높은 히트 비율을 유지하며, 전체 재계산보다 처리량이 2배 이상 증가.
사용된 스토리지 계층은 로컬 NVMe 파일 시스템이었습니다. 스토리지 지연은 CPU 메모리보다 높지만, 스토리지에서 캐시 히트는 재프리필보다 훨씬 저렴합니다.
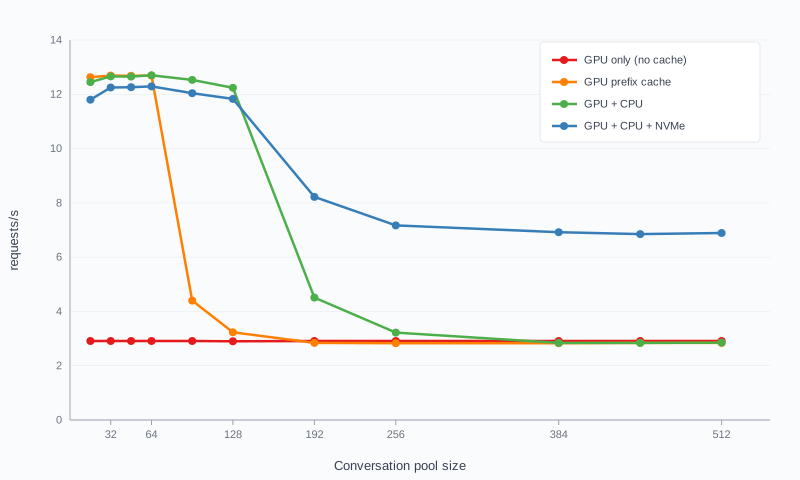
전체 벤치마크 스크립트와 결과는 neuralmagic/fs-offload-experiments에 호스팅되어 있습니다.
감사의 말
Liran Schour, Chang Guo, Srinivas Krovvidi, Rotem Shavitt, Effi Ofer, Omer Paz, Kfir Toledo, Michal Malka 및 더 넓은 커뮤니티에 계층적 KV 캐시 오프로딩 프레임워크에 기여해 주셔서 감사합니다.